CTA 訊號建模
本頁譯自英文,內容以英文版本為準。 閱讀英文版
問題
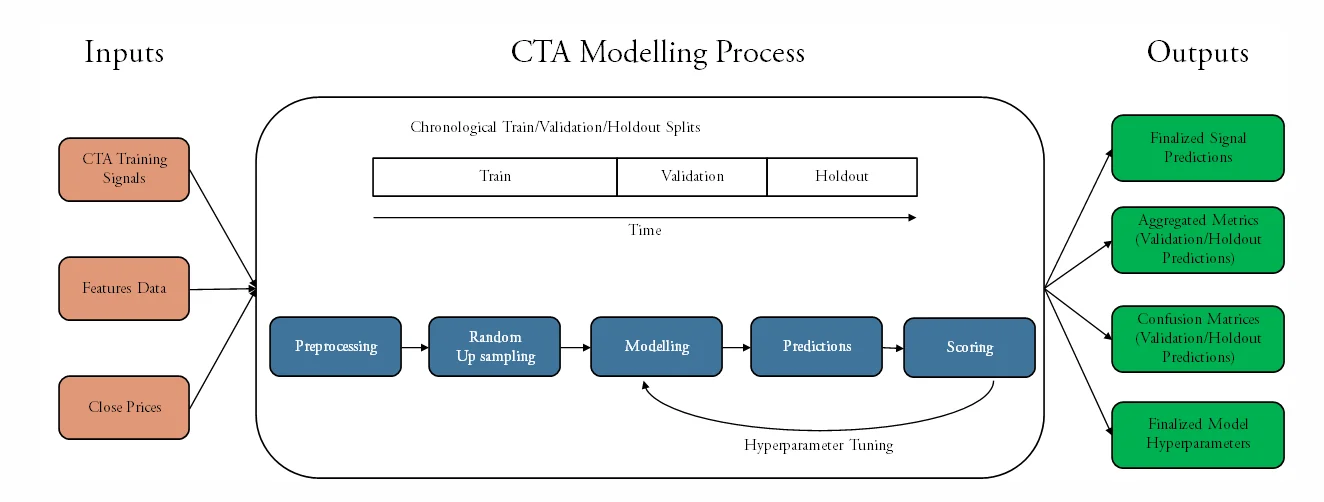
我們能否運用下列方法,為 CTA 策略建立監督式學習模型?
- 依時間順序切分資料
- 防止資料洩漏,並模擬正確的回測
- 隨機上採樣(非合成)
- 處理類別不平衡
- 透過集成樹演算法進行特徵轉換的建模
主要任務輸入:
- 日期
- 驗證期起始日
- 保留期起始日
- 保留期結束日
- 最佳化指標(準確率 Accuracy、精確率 Precision、召回率 Recall、F1、負對數損失 Neg Log Loss)
- 訓練頻率(年、季、月、日)
輸出:
- 多頭或空頭的預測訊號
- 驗證期與保留期的彙總指標
- 驗證期與保留期的混淆矩陣
- 最終確定的模型超參數
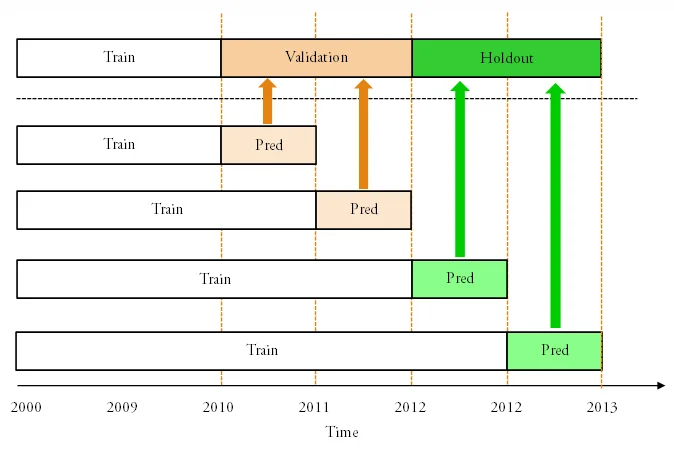
依時間順序切分資料
- 依時間順序將資料切分為訓練/驗證/保留三部分
- 假設回測時以固定時間間隔重新訓練模型
- 每年
- 每季
- 每月
- 每日
- 驗證期:
- 此期間的預測會被評分,並用於超參數調校
- 保留期:
- 此期間的預測會被記錄,但不用於任何調校
隨機上採樣(非合成)
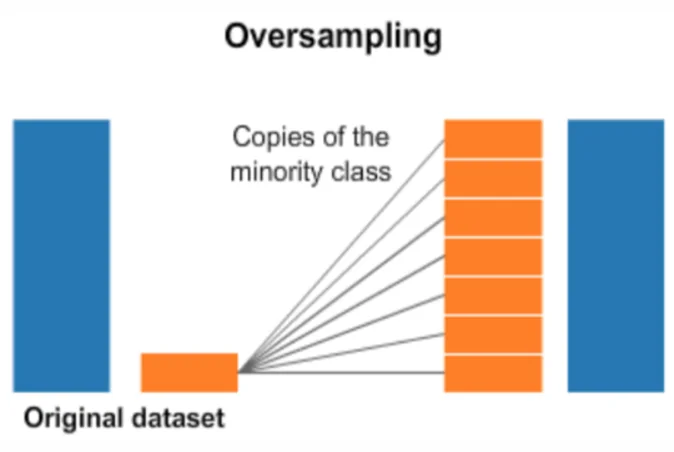
- 訊號建模屬於二元分類問題
- CTA 資產的訊號往往極不平衡(比例約為 1:4)
- 直接套用 ML 模型,大多數時候會預測為多數類別
- 方法
- 對少數類別進行非合成的隨機上採樣,使比例達到 1:1
- 上採樣以可重現的隨機種子實作
建模方法論
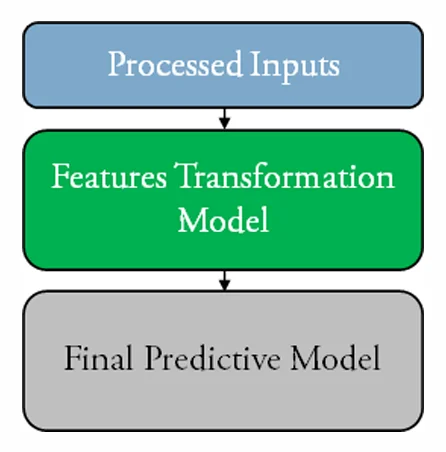
模型架構
- 輸入 -> 特徵轉換(FT)集成樹模型 -> 獨熱編碼(One Hot Encoding) -> 最終預測模型
FT 集成樹模型:
- 使用監督式學習的集成樹演算法進行特徵轉換
- 方法:
- 先以訓練資料進行訓練(且從不接觸測試資料)
- 之後作為特徵轉換步驟使用,其中:
- 將預處理後的資料輸入模型
- 每棵樹的葉節點作為下一個模型的輸入特徵
- 有助於捕捉資料中的非線性關係,同時發揮某種正則化的作用
最終預測模型:
- 最先進的梯度提升樹演算法
- 接收上一層經特徵轉換並進行獨熱編碼的資料,執行二元分類預測
CTA 建模流程
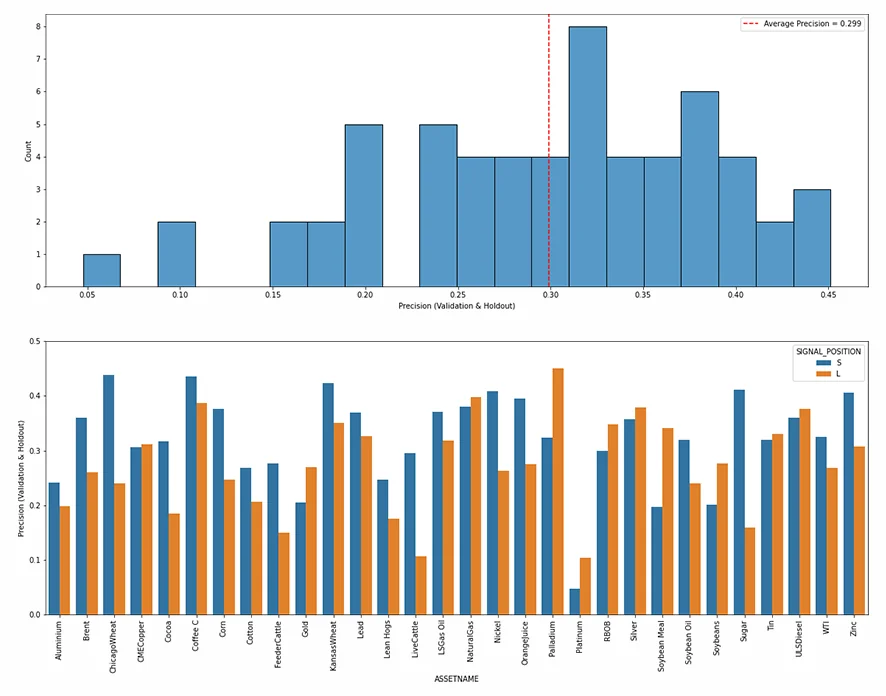
精確率圖表
精確率(Precision) = (𝑻𝒓𝒖𝒆 𝑷𝒐𝒔𝒊𝒕𝒊𝒗𝒆)/(𝑷𝒓𝒆𝒅𝒊𝒄𝒕𝒆𝒅 𝑷𝒐𝒔𝒊𝒕𝒊𝒗𝒆),即真陽性除以預測陽性,針對每種訊號部位(多頭/空頭)在驗證期與保留期的合併預測計算
圖表 1:精確率直方圖:
- 30 項資產 x 2 種訊號部位 = 60
- 平均值 = 0.299
- 眾數介於 0.30 至 0.35 之間
圖表 2:各資產的精確率長條圖
- 每項資產有兩個精確率數值(每種訊號部位各一個)
- 大多數資產在兩種訊號部位上的精確率結果相近