Modelagem de sinais CTA
Traduzido do inglês. O texto em inglês é a referência. Ler em inglês
Perguntas
É possível criar um modelo de aprendizado supervisionado para uma estratégia CTA com as abordagens abaixo?
- Divisão cronológica dos dados
- Para evitar vazamento de dados (data leakage) e simular um backtesting adequado
- Sobreamostragem aleatória (não sintética)
- Para tratar o desbalanceamento de classes
- Modelagem com transformação de variáveis (features) por meio de algoritmos de ensemble de árvores
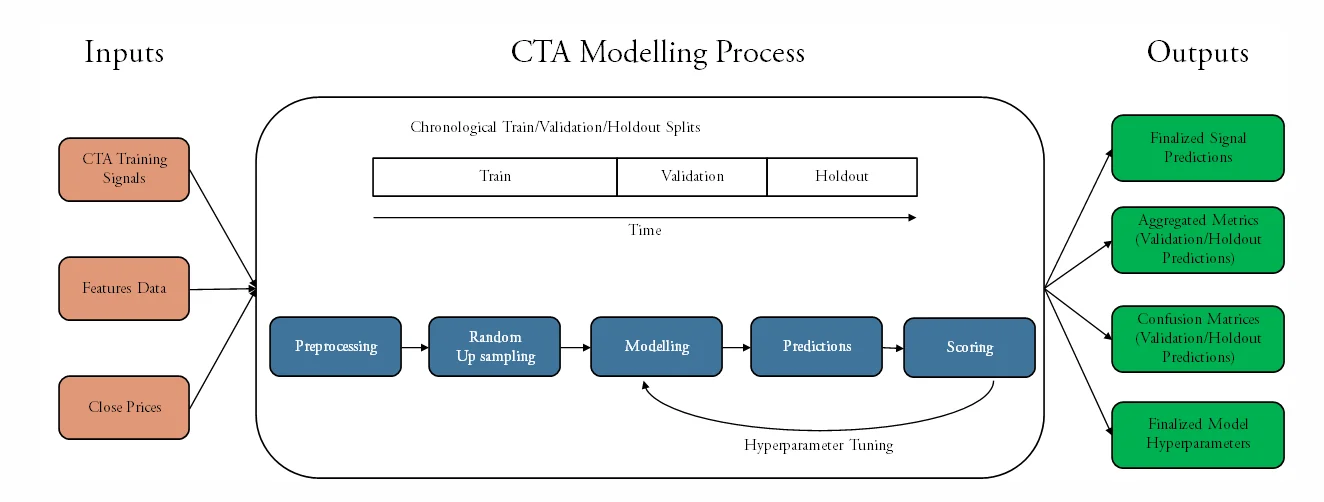
Principais insumos da tarefa:
- Datas
- Início da validação
- Início do holdout
- Fim do holdout
- Métrica de otimização (acurácia, precisão, recall, F1, Neg Log Loss)
- Frequência de treinamento (ano, trimestre, mês, dia)
Resultados:
- Sinais previstos, comprados ou vendidos
- Métricas agregadas para validação vs. holdout
- Matrizes de confusão para validação vs. holdout
- Hiperparâmetros finais do modelo
Divisão cronológica dos dados
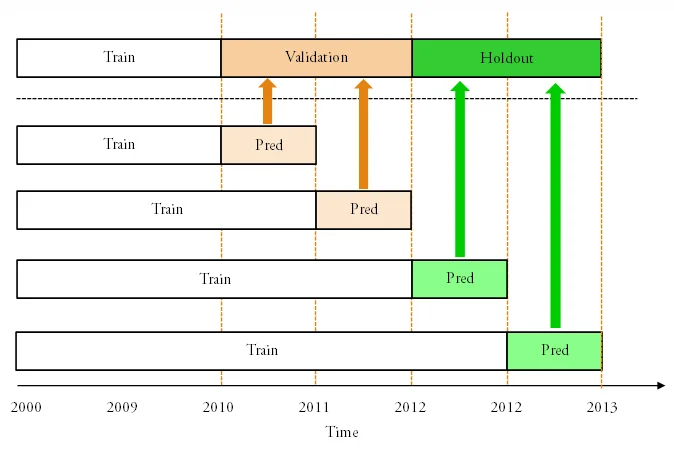
- Divisão cronológica dos dados em subconjuntos de treinamento/validação/holdout
- Pressupõe backtesting com intervalo de tempo fixo de retreinamento do modelo
- Anual
- Trimestral
- Mensal
- Diário
- Período de validação:
- As previsões deste período são pontuadas e usadas para o ajuste de hiperparâmetros
- Período de holdout:
- As previsões deste período são registradas, mas não são usadas para nenhum ajuste
Sobreamostragem aleatória (não sintética)
- A modelagem de sinais é um problema de classificação binária
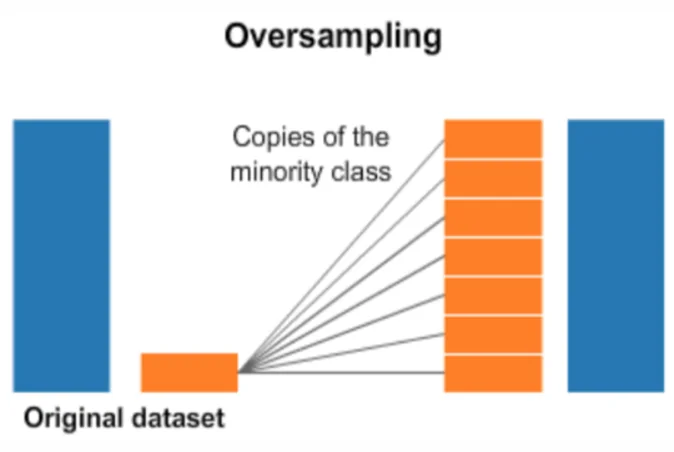
- Os sinais dos ativos CTA tendem a ser muito desbalanceados (razão de cerca de 1:4)
- Aplicar o modelo de ML diretamente resultará, na maior parte do tempo, na previsão da classe majoritária
- Abordagem
- Realiza-se uma sobreamostragem aleatória não sintética da classe minoritária até a razão de 1:1
- A sobreamostragem é implementada com uma semente aleatória reproduzível
Metodologia de modelagem
Estrutura do modelo
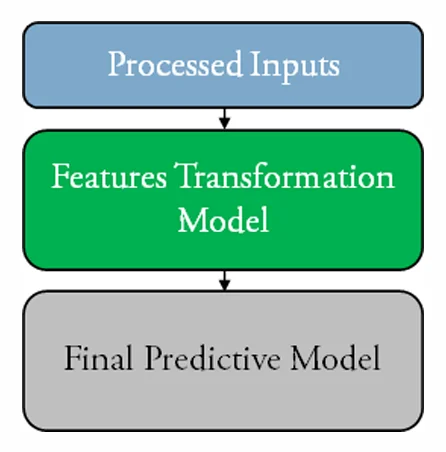
- Insumos -> modelo de ensemble de árvores para transformação de variáveis (FT) -> One Hot Encoding -> modelo preditivo final
Modelo de ensemble de árvores FT:
- Usa um algoritmo de ensemble de árvores de aprendizado supervisionado para a transformação de variáveis
- Abordagem:
- Treinado primeiro com os dados de treinamento (e nunca exposto aos dados de teste)
- Usado em seguida como etapa de transformação de variáveis, em que:
- Os dados pré-processados alimentam o modelo
- As folhas de cada árvore são usadas como variáveis de entrada no modelo seguinte
- Ajuda a capturar relações não lineares nos dados, atuando ao mesmo tempo como uma forma de regularização
Modelo preditivo final:
- Algoritmo de árvores com gradient boosting de última geração
- Recebe os dados com variáveis transformadas e codificados em one-hot da camada anterior e realiza a previsão de classificação binária
Processo de modelagem CTA
Gráficos de precisão
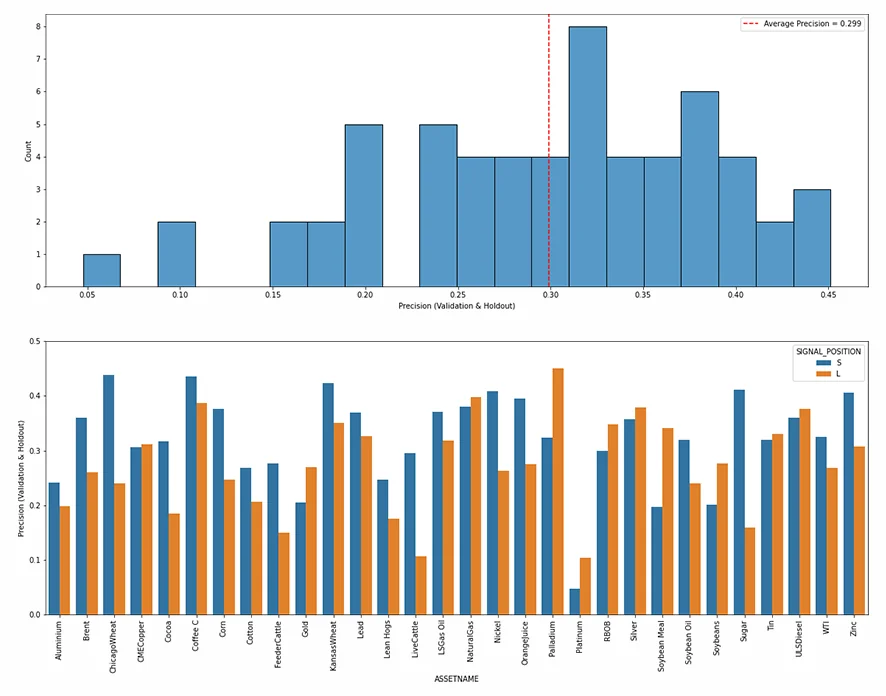
Precisão = (verdadeiros positivos)/(positivos previstos) para as previsões combinadas dos períodos de validação e holdout, para cada posição de sinal (comprada/vendida)
Gráfico 1: Histograma da precisão:
- 30 ativos x 2 posições de sinal = 60
- Média = 0.299
- A moda está entre 0.30 e 0.35
Gráfico 2: Gráfico de barras da precisão por ativo
- Cada ativo tem dois valores de precisão (um para cada posição de sinal)
- A maioria dos ativos tem resultados de precisão semelhantes para as duas posições de sinal