CTA 시그널 모델링
영어 원문을 번역한 페이지입니다. 영어 원문이 기준입니다. 영어 원문 보기
질문
아래 접근 방식을 사용하여 CTA 전략에 대한 지도 학습 모델을 만들 수 있습니까?
- 시간 순서에 따른 데이터 분할
- 데이터 누수를 방지하고 적절한 백테스트를 모사하기 위해
- 무작위 업샘플링(비합성)
- 클래스 불균형을 처리하기 위해
- 앙상블 트리 알고리즘을 통한 피처 변환을 사용한 모델링
주요 작업 입력값:
- 일자
- 검증 시작일
- 홀드아웃 시작일
- 홀드아웃 종료일
- 최적화 지표(정확도, 정밀도, 재현율, F1, 음의 로그 손실)
- 학습 주기(연, 분기, 월, 일)
출력값:
- 롱 또는 숏에 대한 예측 시그널
- 검증 기간 대 홀드아웃 기간의 집계 지표
- 검증 기간 대 홀드아웃 기간의 혼동 행렬
- 최종 확정된 모델 하이퍼파라미터
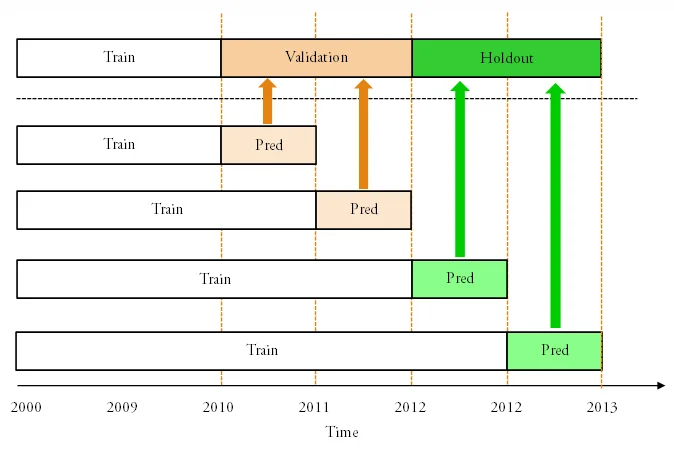
시간 순서에 따른 데이터 분할
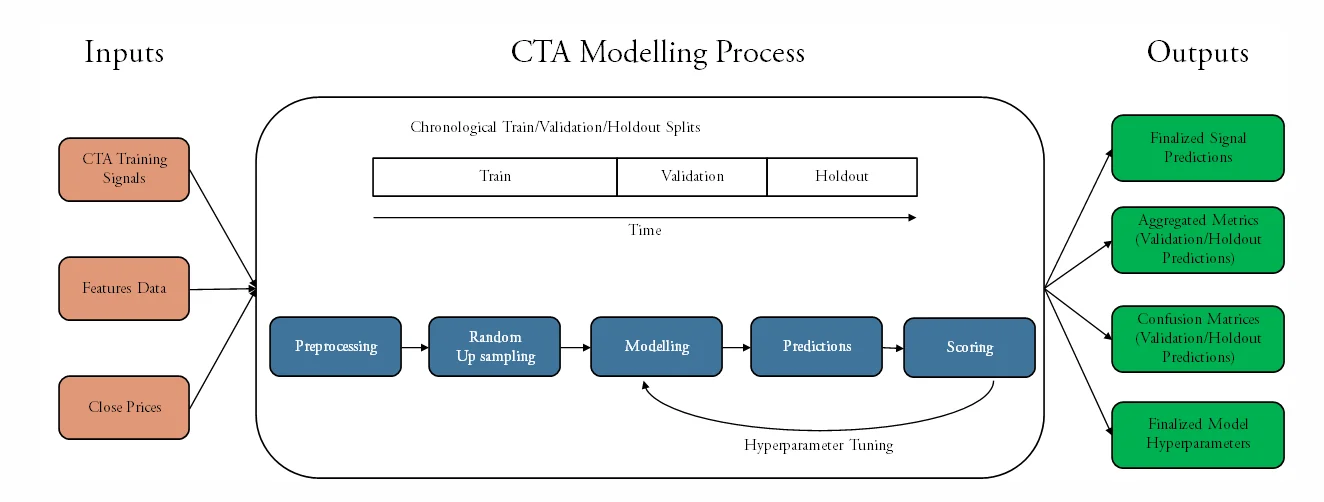
- 시간 순서에 따라 데이터를 학습/검증/홀드아웃 구간으로 분할
- 고정된 시간 간격으로 모델을 재학습하는 백테스트를 가정
- 연간
- 분기
- 월간
- 일간
- 검증 기간:
- 이 기간의 예측은 점수화하여 하이퍼파라미터 튜닝에 사용
- 홀드아웃 기간:
- 이 기간의 예측은 기록하지만 어떠한 튜닝에도 사용하지 않음
무작위 업샘플링(비합성)
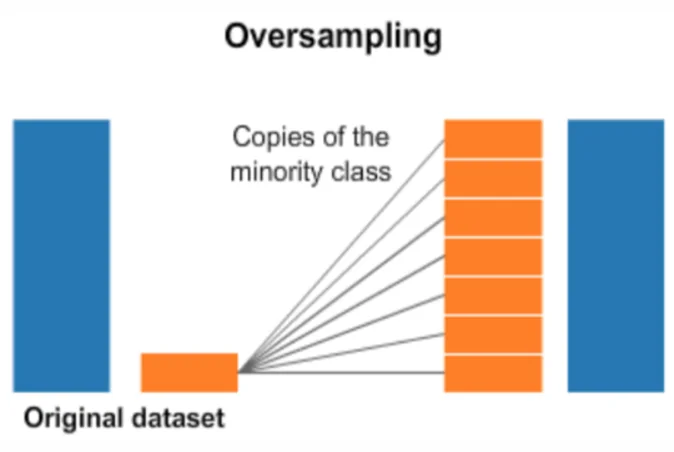
- 시그널 모델링은 이진 분류 문제
- CTA 자산의 시그널은 매우 불균형한 경향(약 1:4 비율)
- ML 모델을 그대로 적용하면 대부분 다수 클래스를 예측하게 됨
- 접근 방법
- 소수 클래스를 비합성 무작위 업샘플링하여 비율을 1:1로 맞춤
- 업샘플링은 재현 가능한 무작위 시드로 구현
모델링 방법론
모델 프레임워크
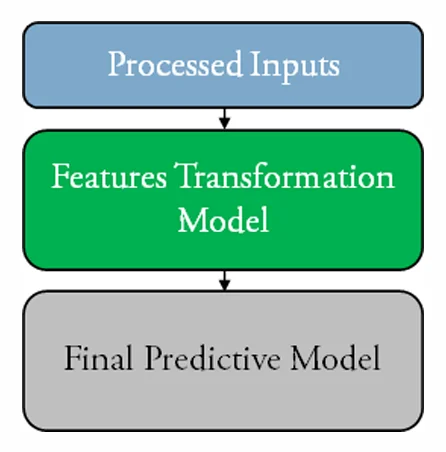
- 입력값 -> 피처 변환(FT) 앙상블 트리 모델 -> 원-핫 인코딩 -> 최종 예측 모델
FT 앙상블 트리 모델:
- 피처 변환에 지도 학습 앙상블 트리 알고리즘을 사용
- 접근 방법:
- 먼저 학습 데이터로 학습(테스트 데이터에는 절대 노출하지 않음)
- 이후 다음과 같은 피처 변환 단계로 사용:
- 전처리한 데이터를 모델에 입력
- 각 트리의 리프를 다음 모델의 입력 피처로 사용
- 정규화의 한 형태로 작용하면서 데이터의 비선형 관계를 포착하는 데 도움
최종 예측 모델:
- 최첨단 그래디언트 부스팅 트리 알고리즘
- 이전 계층에서 피처 변환 후 원-핫 인코딩한 데이터를 입력받아 이진 분류 예측을 수행
CTA 모델링 프로세스
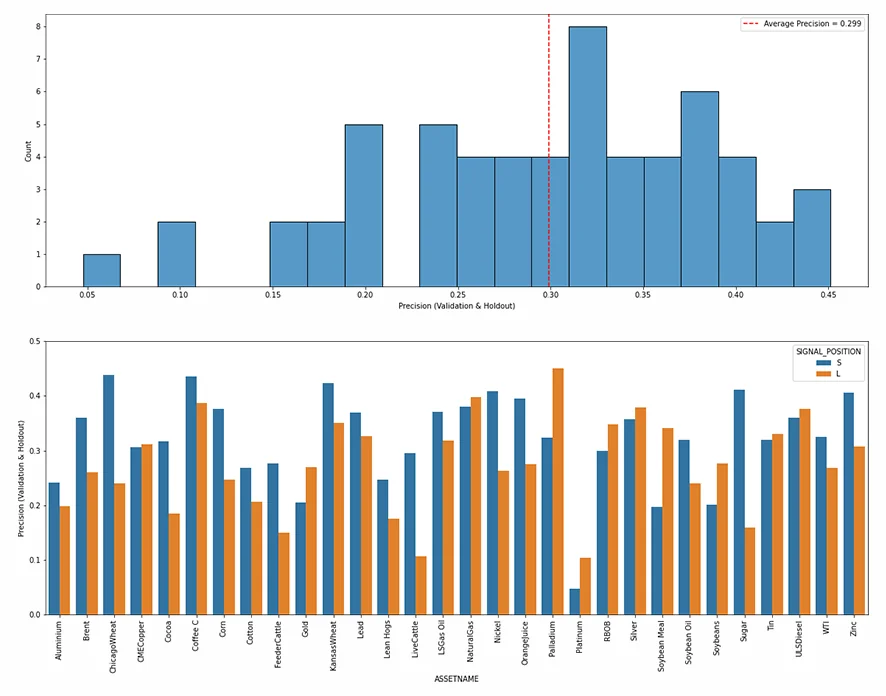
정밀도 차트
각 시그널 포지션(롱/숏)에 대해 검증 기간과 홀드아웃 기간의 예측을 합산한 정밀도(Precision) = (𝑻𝒓𝒖𝒆 𝑷𝒐𝒔𝒊𝒕𝒊𝒗𝒆)/(𝑷𝒓𝒆𝒅𝒊𝒄𝒕𝒆𝒅 𝑷𝒐𝒔𝒊𝒕𝒊𝒗𝒆)
차트 1: 정밀도 히스토그램:
- 자산 30개 x 시그널 포지션 2개 = 60
- 평균 = 0.299
- 최빈값은 0.30~0.35 사이
차트 2: 자산별 정밀도 막대 차트
- 각 자산은 두 개의 정밀도 값을 가짐(시그널 포지션별로 하나씩)
- 대부분의 자산은 두 시그널 포지션에서 비슷한 정밀도 결과를 보임