CTA シグナルのモデリング
英語からの翻訳です。英語の原文を正とします。 英語で読む
問い
以下のアプローチを用いて、CTA 戦略の教師あり学習モデルを構築できるでしょうか。
- 時系列順のデータ分割
- データ・リーケージを防ぎ、適切なバックテストを再現するため
- ランダム・アップサンプリング(非合成)
- クラスの不均衡に対処するため
- アンサンブル木アルゴリズムによる特徴量変換を用いたモデリング
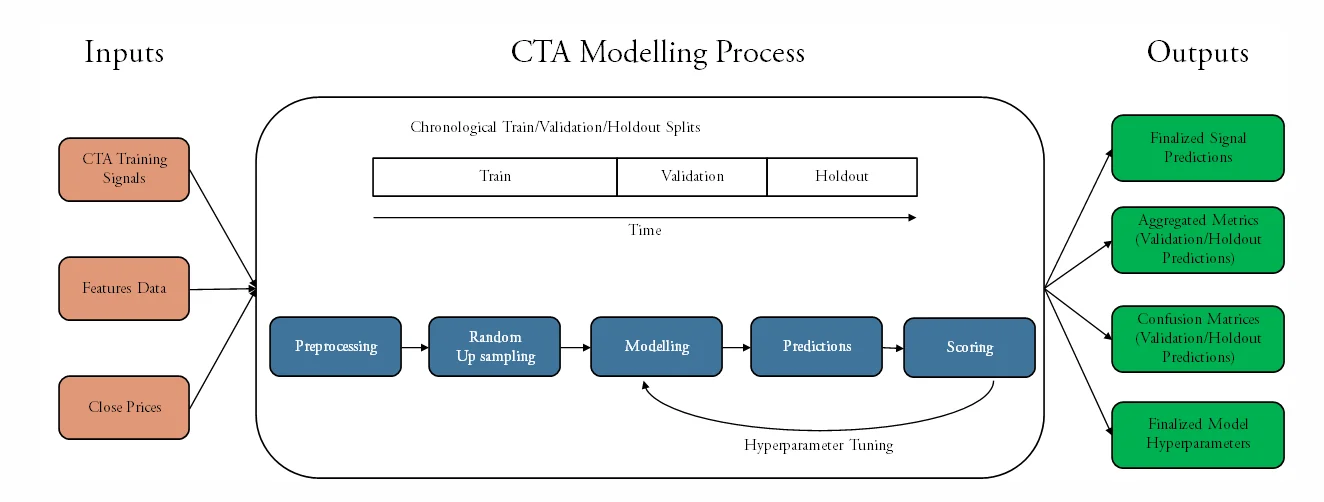
主なタスク入力:
- 日付
- 検証期間の開始日
- ホールドアウト期間の開始日
- ホールドアウト期間の終了日
- 最適化指標(正解率(Accuracy)、適合率(Precision)、再現率(Recall)、F1、負の対数損失(Neg Log Loss))
- 学習頻度(年、四半期、月、日)
出力:
- ロングまたはショートの予測シグナル
- 検証期間とホールドアウト期間の集計指標
- 検証期間とホールドアウト期間の混同行列
- 確定したモデルのハイパーパラメータ
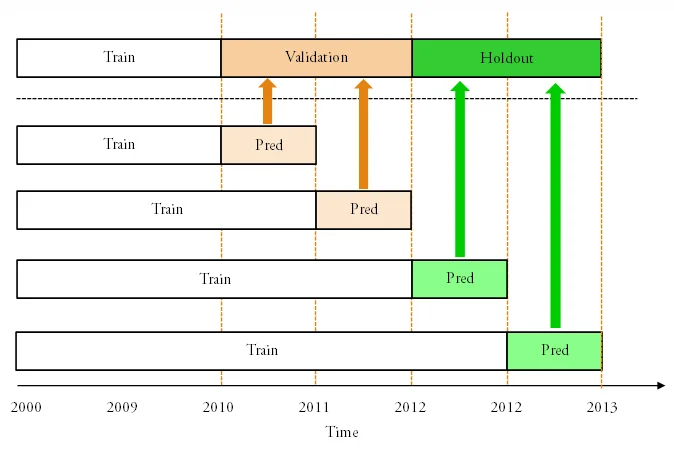
時系列順のデータ分割
- データを時系列順に学習/検証/ホールドアウトに分割
- 一定の時間間隔でモデルを再学習するバックテストを想定
- 年次
- 四半期
- 月次
- 日次
- 検証期間:
- この期間の予測はスコアリングされ、ハイパーパラメータの調整に用いられます
- ホールドアウト期間:
- この期間の予測は記録されますが、いかなる調整にも用いられません
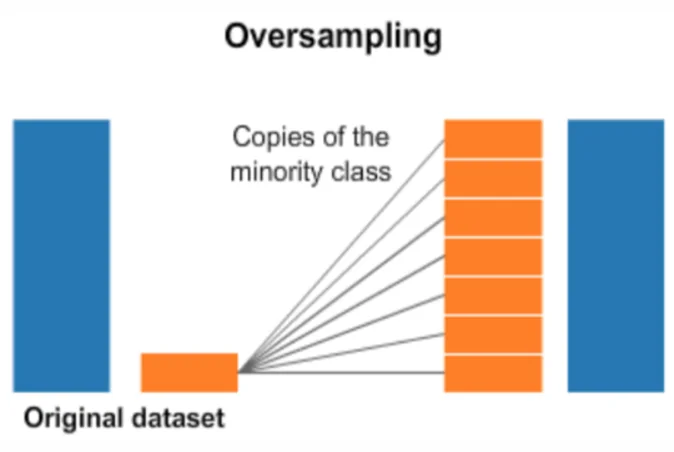
ランダム・アップサンプリング(非合成)
- シグナルのモデリングは二値分類の問題
- CTA の資産のシグナルは非常に不均衡になりやすい(比率は約 1:4)
- ML モデルをそのまま適用すると、ほとんどの場合に多数派クラスを予測する結果となります
- アプローチ
- 少数派クラスについて、非合成のランダム・アップサンプリングを比率 1:1 まで行います
- アップサンプリングは、再現可能なランダム・シードを用いて実装します
モデリングの手法
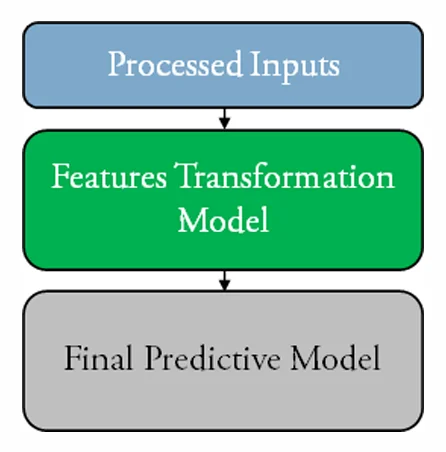
モデルのフレームワーク
- 入力 -> 特徴量変換(FT)アンサンブル木モデル -> ワンホット・エンコーディング -> 最終予測モデル
FT アンサンブル木モデル:
- 特徴量変換に教師あり学習のアンサンブル木アルゴリズムを用います
- アプローチ:
- まず学習データで学習させます(テスト・データには一切触れさせません)
- その後、次のような特徴量変換のステップとして用います。
- 前処理したデータをモデルに入力します
- 各木のリーフを、次のモデルの入力特徴量として用います
- 正則化の一形態として機能しつつ、データ内の非線形な関係を捉えるのに役立ちます
最終予測モデル:
- 最先端の勾配ブースティング木アルゴリズム
- 前の層で特徴量変換し、ワンホット・エンコーディングしたデータを受け取り、二値分類の予測を行います
CTA のモデリング・プロセス
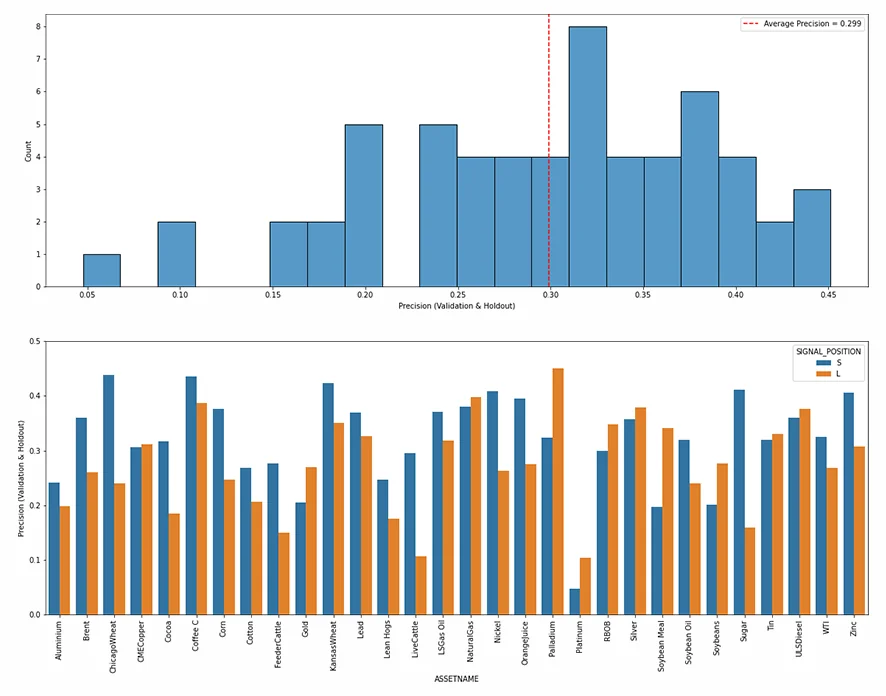
適合率のチャート
各シグナル・ポジション(ロング/ショート)について、検証期間とホールドアウト期間の予測を合わせた適合率(Precision)= (𝑻𝒓𝒖𝒆 𝑷𝒐𝒔𝒊𝒕𝒊𝒗𝒆)/(𝑷𝒓𝒆𝒅𝒊𝒄𝒕𝒆𝒅 𝑷𝒐𝒔𝒊𝒕𝒊𝒗𝒆)
チャート 1:適合率のヒストグラム
- 30 資産 x 2 シグナル・ポジション = 60
- 平均 = 0.299
- 最頻値は 0.30~0.35 の間
チャート 2:資産ごとの適合率の棒グラフ
- 各資産は 2 つの適合率の値を持ちます(シグナル・ポジションごとに 1 つ)
- 大半の資産で、両方のシグナル・ポジションの適合率は同程度です