
過度擬合分析
本頁譯自英文,內容以英文版本為準。 閱讀英文版
過度擬合的風險
概述
- 如同所有系統化交易策略,AiLA 策略也面臨建立在過度擬合結果之上的風險。
- 即使立意良善並遵循當前最佳實務,也無法保證能避免過度擬合,例如在無意間受到過去經驗的影響。
- 為積極降低過度擬合的影響,AiLA 的策略開發嚴格遵循一套原則。
大綱
- 類型:彙整在不同策略研發步驟中常見的過度擬合來源。
- 風險:就可能發生過度擬合的風險,指出 AiLA 策略流程中的主要步驟。
- 緩解:說明 AiLA 為降低過度擬合風險所遵循的原則。
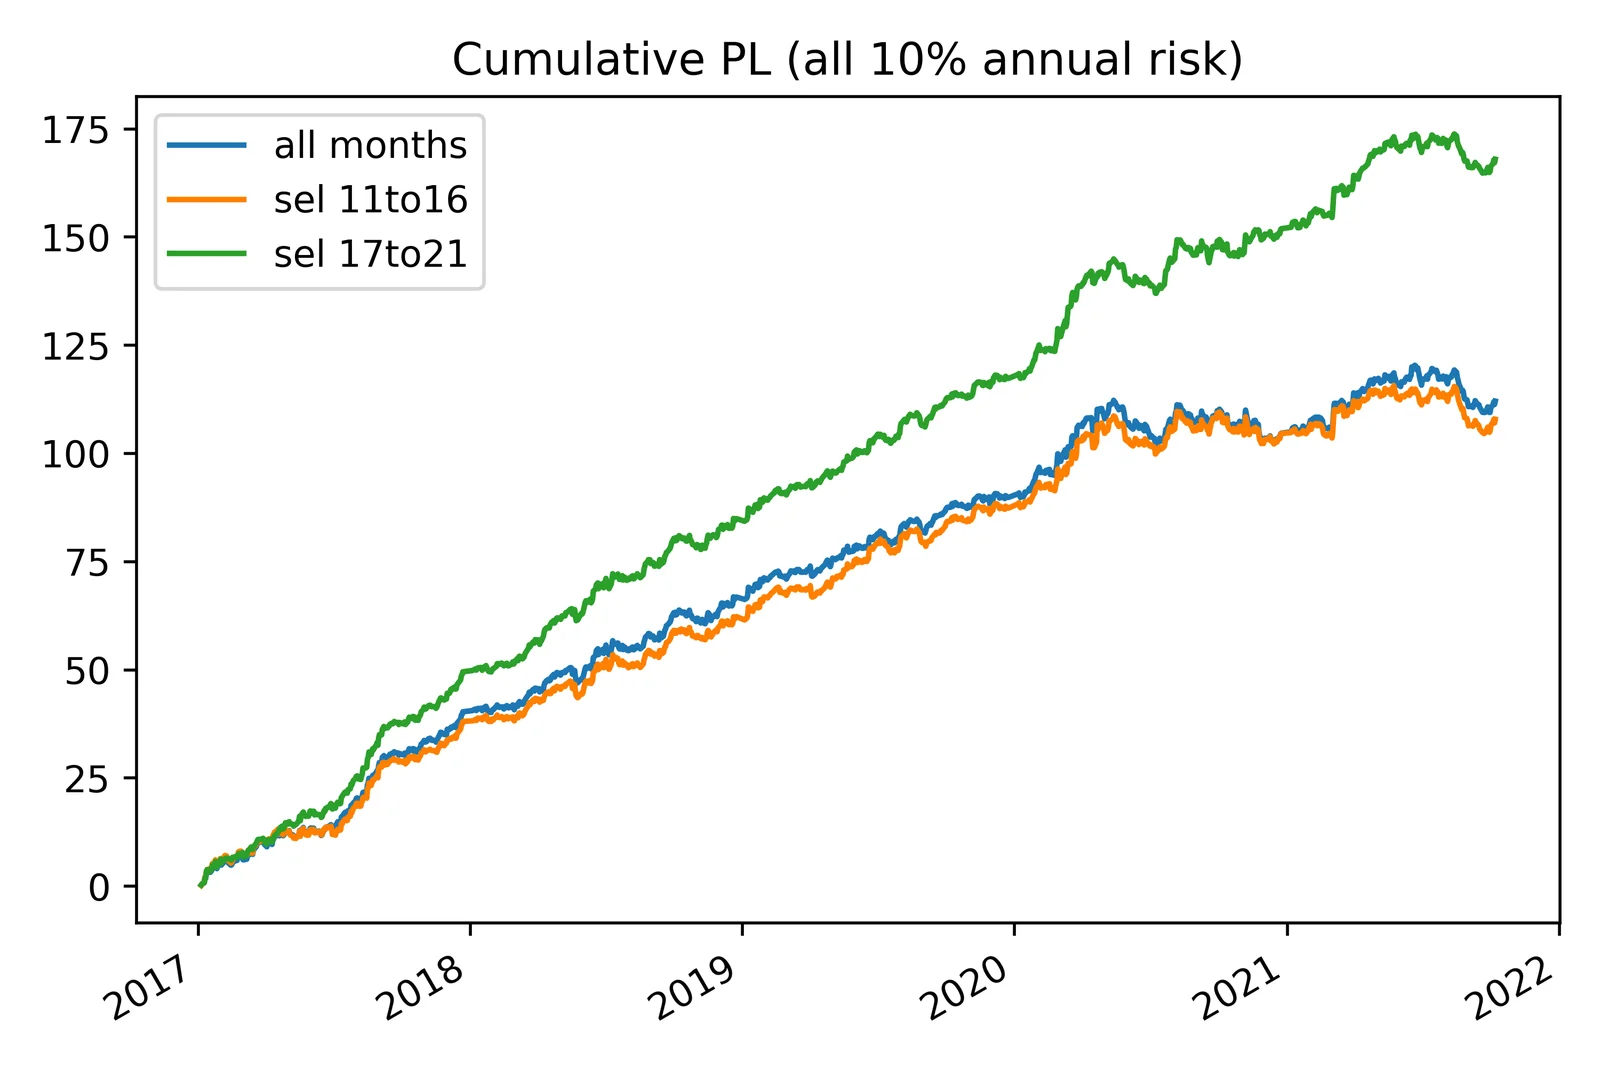
- 過度擬合策略結果的示意圖,詳情請參閱觀點文章 [Overfitting Risk]。
- 策略改良以與評估時相同的資料進行設計,因而呈現優於預設策略的績效(2017 年至 2021 年)。
- 同一改良策略若以不同的資料(2011 年至 2016 年)檢驗,顯示該假設並無影響。
過度擬合的類型
過度擬合通常在研發流程的不同階段加以考量,以下為兩種常見類型。
這些術語在機器學習(ML)領域中很常見,但這些問題並非 ML 所獨有,而是適用於任何參考資料的作業。
訓練(設計)階段
- 指在策略訓練或設計階段發生的過度擬合。
- 在此階段,過度擬合在某種程度上無可避免,並會使用不同方法處理因擬合樣本內資料雜訊之關係所產生的問題。
測試階段
- 指在策略測試階段發生的過度擬合;此階段原本無意產生任何過度擬合。
- 這通常源自多重測試情境,例如「測試多種並挑選最佳者」或「測試、修改後再測試」,而在最終評估時(往往是無意間)忽略了導致結果被美化的原因。
處理過度擬合的措施範例
訓練(設計)階段
- 使用交叉驗證技術,處理在樣本外資料中重現(一般化)結果的能力。
- 使用正則化技術,降低模型複雜度及對特定資料樣本的敏感度。
- 可使用集成模型降低模型結果的變異數,使其在過度擬合方面更加穩健。
測試階段
- 記錄所進行的多次測試,並使用校正或估計其影響的方法,例如族系(familywise)檢定或平減後績效。
- 就預先登錄的測試細節及使用不同(「盲測」)資料,執行嚴格的政策。
上方的示意圖 [Overfitting Risk] 很容易透過交叉驗證揭露;然而,測試期間(無意間)發生的過度擬合通常更難以量化。
風險領域
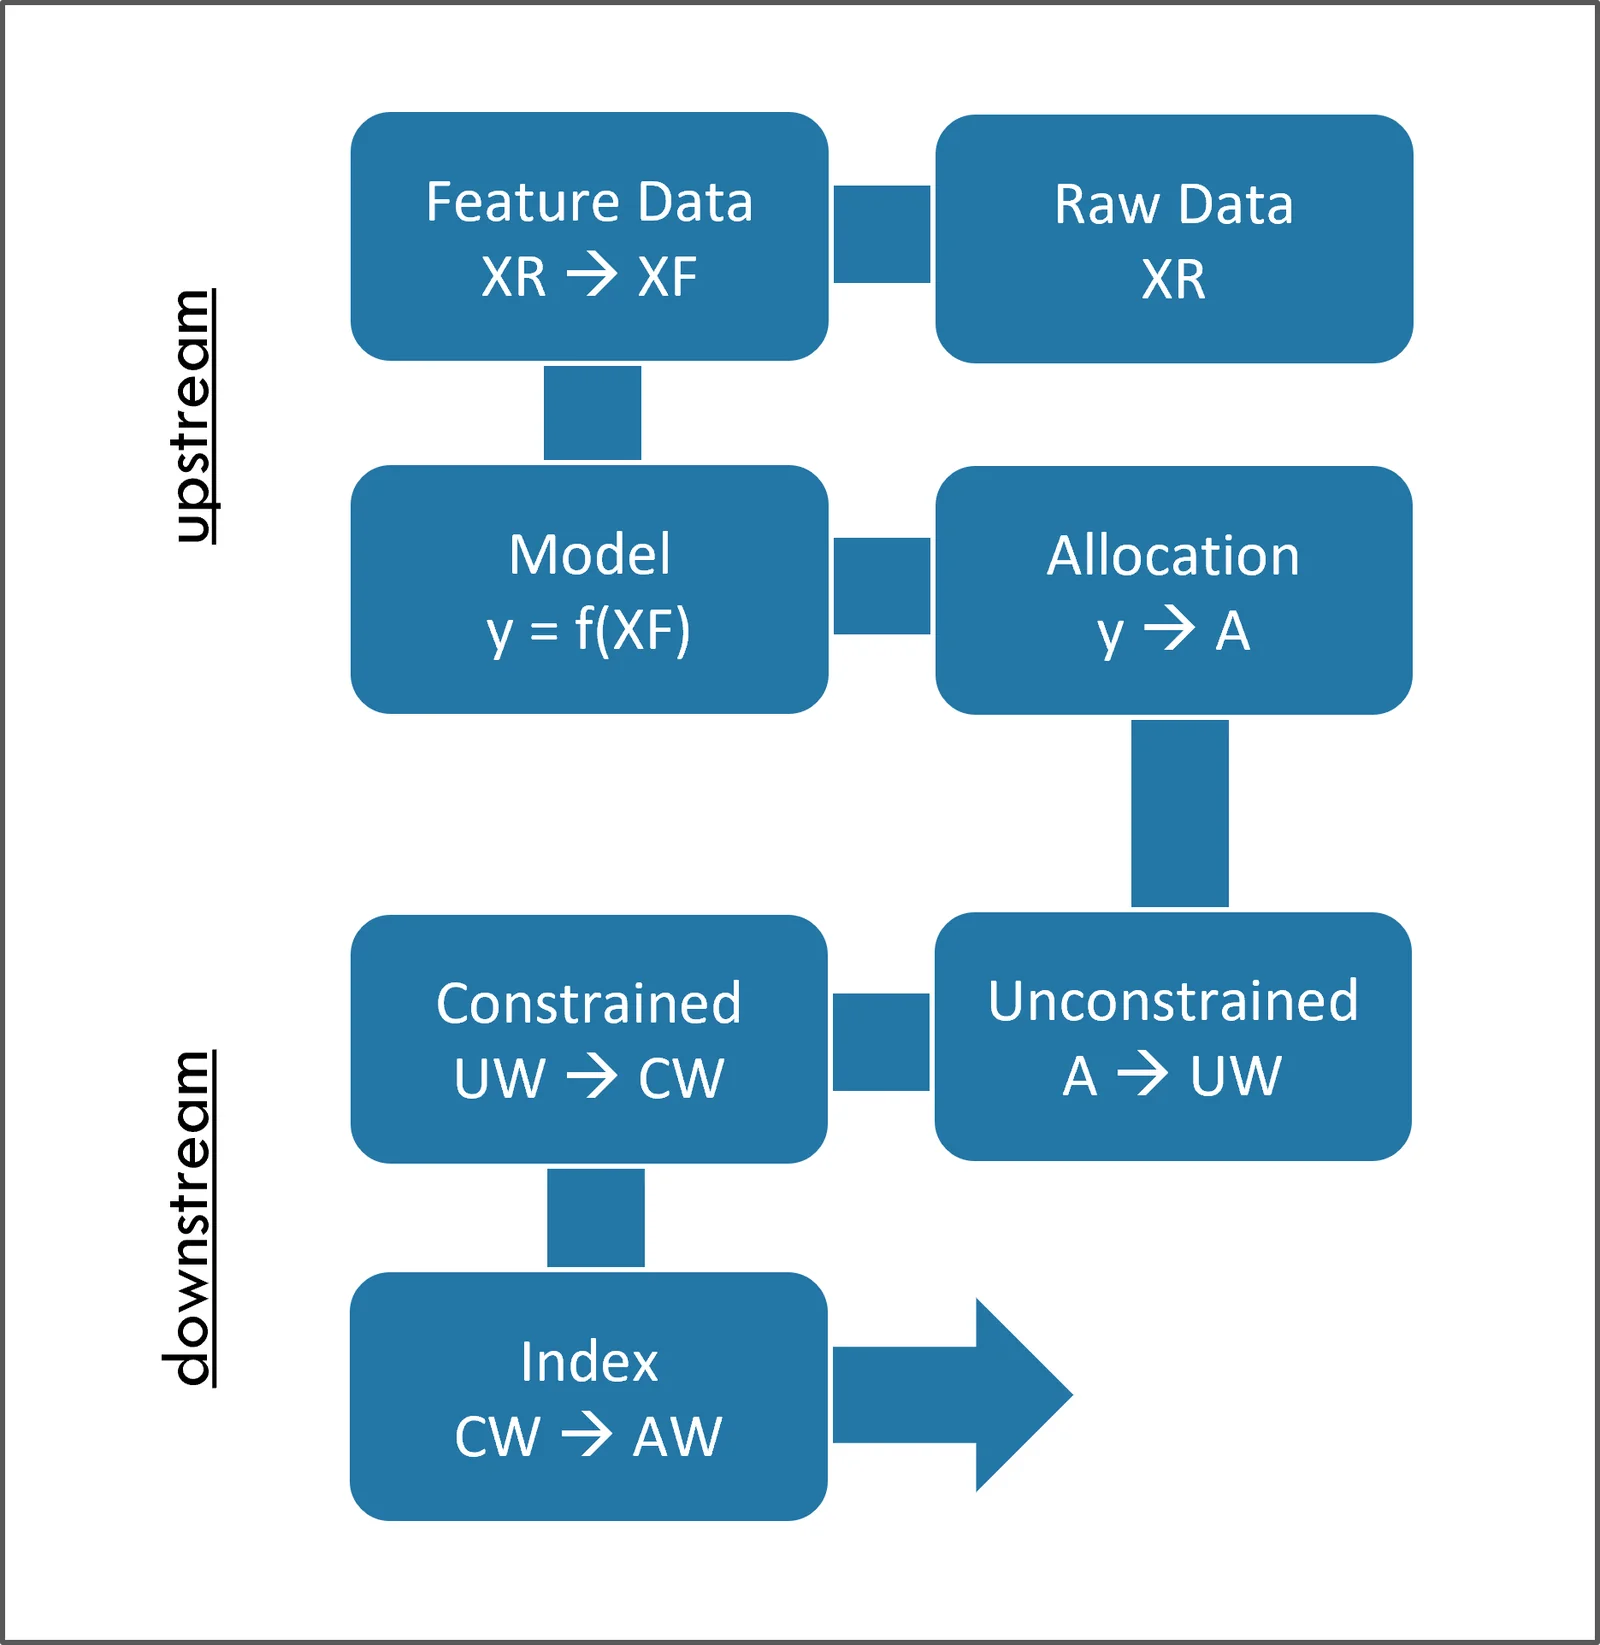
在 AiLA 策略開發流程的各個環節中,都有若干可能發生過度擬合的機會。
具特定風險的領域
- 關於微觀/總體資料及特徵定義的選擇:這些選擇涉及如何讓資料以最佳方式揭露重要因子,同時不預設策略應如何使用這些資料。
- 資產模型的訓練與篩選:在此使用上述技術處理過度擬合,所有模型評估與超參數調校均使用預先決定的訓練/驗證資料集進行。
- 最終的上游配置方法,其參數也使用相同的訓練/驗證資料集進行最佳化。
- 下游指數建構將不同的資產配置模型組合成不同類型的指數。此流程以固定方法為基礎,著重於在整個投資組合中實現風險分散,而非資產績效。然而,此步驟包含參數選擇與指數資產篩選,必須避免引入選擇偏誤。
緩解原則
為降低過度擬合的影響,我們嚴格遵循多項原則。
然而須注意的是,所有方法均有其不足之處,對所有決策都必須審慎以對。
所遵循的原則
- 所有特徵資料在可預見的未來均應可取得,且資產模型凍結後,資料及特徵定義均不再變更。資料與特徵定義的選擇,係依據從基本面/主觀判斷型原物料商品交易實務中取得的領域知識,這些知識可能隨時間重新檢視。然而,鑑於著重於穩定的因子,所採用的原則是同時凍結資料面,以避免透過此類檢視/更新流程而產生潛在的過度擬合。
- 資產模型的訓練與篩選嚴格以截至 2016 年底可取得的資料為基礎;這也與多數具流動性原物料商品之資產配置模型凍結並投入實盤交易的時點相符。因此,此期間也用於新研究及資產模型的訓練/驗證。
- 在樣本內最佳化最終資產配置方法的參數,可能導致選擇偏誤。然而,參數值範圍設有上下限,預期不會對結果造成劇烈影響,且樣本外結果中未觀察到顯著的過度擬合,也驗證了這些結果。
- 測試整體上游資產配置模型時,必須在使用自 1 Jan 2017 起的保留資料取得樣本外測試結果之前,凍結所有細節。圍繞凍結方法並使用保留資料集進行最終上游評估的嚴格實務(亦即 ML 社群的常見做法),被選為主要措施,以降低低估多重檢定偏誤對結果之美化效果,及/或意外納入此類效果的風險。基於同樣的原因,大多數具流動性的資產配置模型自 1 Jan 2017 起即已凍結,此後未曾變更,因而產生實盤的樣本外結果。
- 下游指數建構所涉及的參數,大多對績效影響有限,例如波動率目標及配置上限等,且相關決策通常基於實務目標,而非指數績效。然而,仍須審慎處理,尤其是對績效影響較大的指數資產篩選。此處的一般原則是以對等的基礎考量各項資產,且唯有在訓練階段有充分理由,並獲得樣本外測試結果支持時,才在資產之間作出區別。