
Análise de overfitting
Traduzido do inglês. O texto em inglês é a referência. Ler em inglês
Risco de overfitting
Visão geral
- Como todas as estratégias sistemáticas de negociação, as estratégias AiLA enfrentam o risco de se basearem em resultados sobreajustados.
- Mesmo com as melhores intenções e seguindo as melhores práticas vigentes, não há garantia de evitar o overfitting, por exemplo, em razão da influência não intencional de experiências passadas.
- Para procurar ativamente minimizar o impacto do overfitting, o desenvolvimento das estratégias AiLA segue rigorosamente um conjunto de princípios.
Estrutura
- Tipos: resumo das fontes de overfitting comumente consideradas em relação às diferentes etapas de P&D de estratégias.
- Risco: destaque das principais etapas do processo de estratégia da AiLA em relação ao risco de ocorrência de overfitting.
- Mitigação: descrição dos princípios seguidos pela AiLA para reduzir o risco de overfitting.
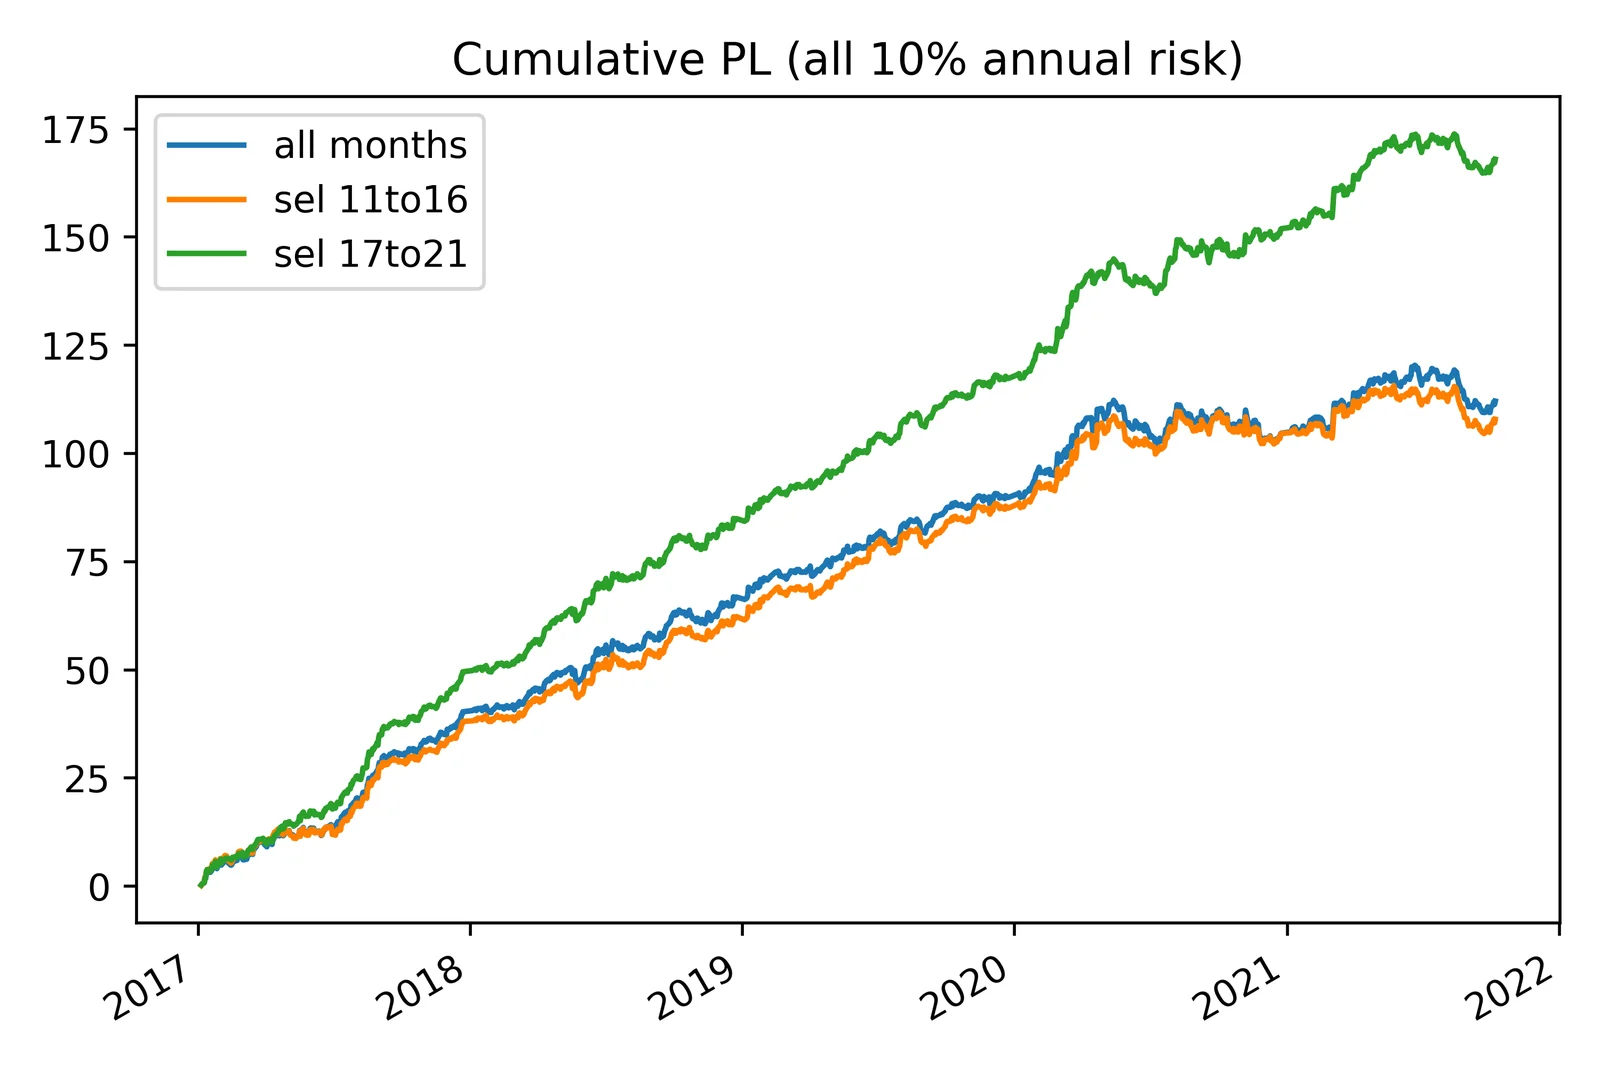
- Ilustração de resultados de uma estratégia sobreajustada; para mais detalhes, ver a perspectiva [Overfitting Risk].
- Uma melhoria da estratégia desenhada com os mesmos dados usados na avaliação apresenta desempenho melhor do que a estratégia padrão (2017 a 2021).
- A mesma estratégia aprimorada, baseada em dados diferentes (2011 a 2016), indica que a hipótese não tem impacto.
Tipos de overfitting
O overfitting costuma ser considerado em diferentes estágios do processo de P&D, sendo dois tipos comuns descritos abaixo.
A terminologia é comum em machine learning (ML); no entanto, os problemas não são específicos de ML, mas se aplicam a qualquer exercício em que dados sejam consultados.
Estágio de treinamento (desenho)
- Refere-se ao overfitting que ocorre durante a fase de treinamento ou desenho da estratégia.
- Aqui, o overfitting é até certo ponto inevitável, e diferentes métodos são usados para tratar os problemas decorrentes do ajuste de uma relação ao ruído dos dados dentro da amostra.
Estágio de teste
- Refere-se ao overfitting que ocorre durante a fase de teste da estratégia, em que nenhum ajuste é pretendido.
- Isso ocorre com frequência em cenários de testes múltiplos, como “testar muitos e escolher o melhor” ou “testar, depois alterar e testar novamente”, em que o motivo que leva a resultados lisonjeiros é negligenciado (muitas vezes de forma não intencional) na avaliação final.
Exemplos de medidas para tratar o overfitting
Estágio de treinamento (desenho)
- Técnicas de validação cruzada são usadas para avaliar a capacidade de reproduzir (generalizar) os resultados em dados fora da amostra.
- Técnicas de regularização são usadas para reduzir a complexidade do modelo, bem como a sensibilidade à amostra específica de dados.
- Modelos de ensemble podem ser usados para reduzir a variância dos resultados do modelo, tornando-o mais robusto em relação ao overfitting.
Estágio de teste
- Registrar os múltiplos testes realizados e usar métodos para corrigir ou estimar o impacto, por exemplo, testes de taxa de erro por família (familywise) ou desempenho deflacionado.
- Aplicar uma política rigorosa de pré-registro dos detalhes dos testes e de uso de dados diferentes (“cegos”).
A ilustração acima [Overfitting Risk] foi facilmente revelada com validação cruzada; no entanto, o overfitting (não intencional) durante os testes é normalmente muito mais difícil de quantificar.
Áreas de risco
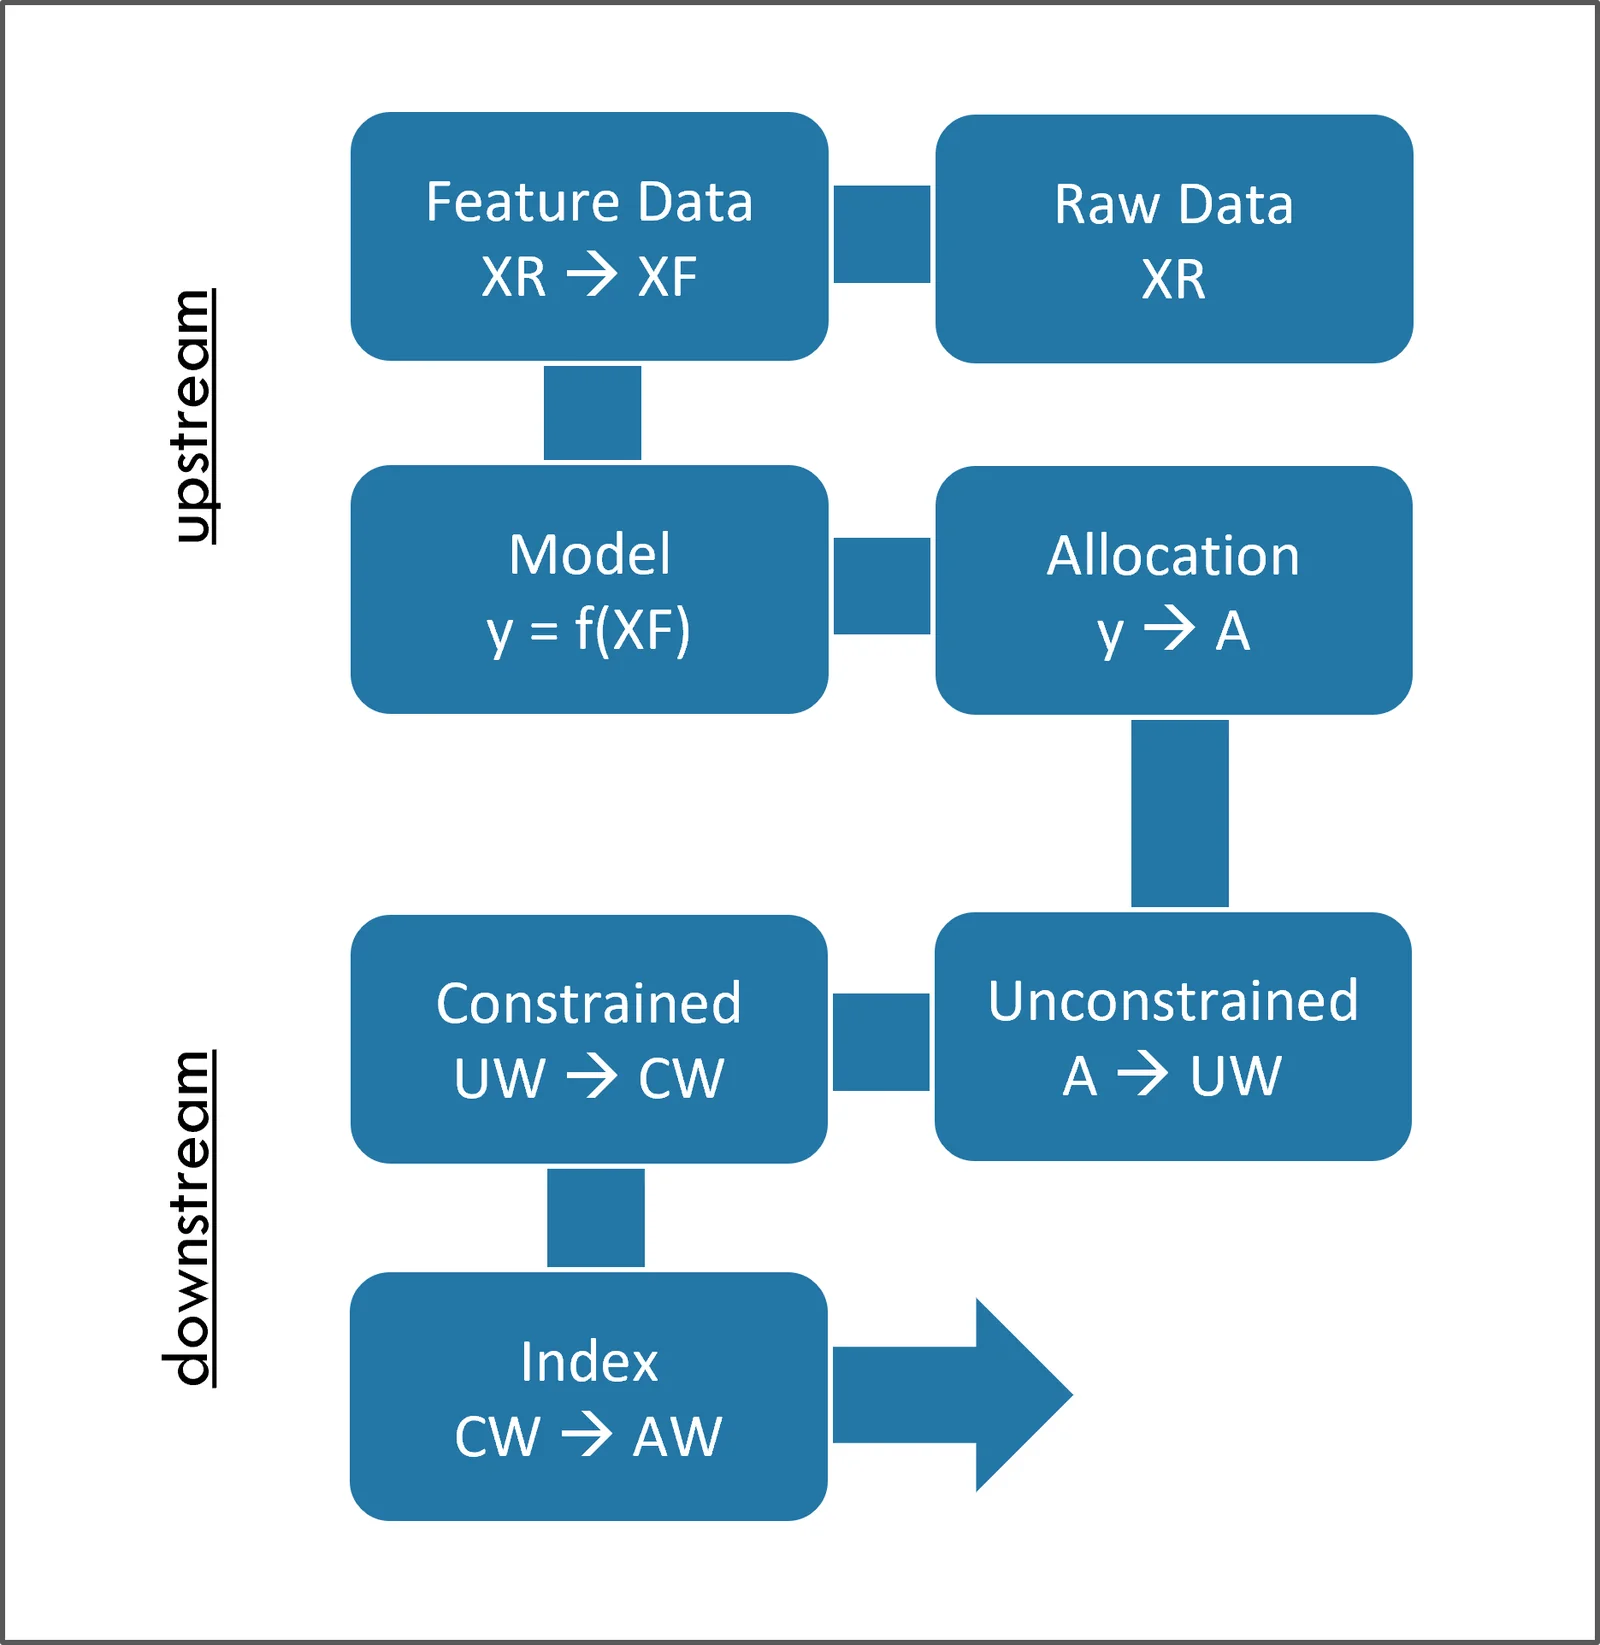
Ao longo de todo o processo de desenvolvimento das estratégias AiLA, há várias oportunidades para a ocorrência de overfitting.
Áreas de risco particular
- Escolhas relativas aos dados micro/macro e à definição das variáveis (features); trata-se de como permitir da melhor forma que os dados exponham fatores importantes, sem implicar como devem ser usados pela estratégia.
- Treinamento e seleção dos modelos dos ativos. Aqui, técnicas como as mencionadas acima são usadas para tratar o overfitting, e toda a avaliação dos modelos e o ajuste de hiperparâmetros são feitos com um conjunto de dados de treinamento/validação predeterminado.
- O método final de alocação upstream também é otimizado em relação aos seus parâmetros com o mesmo conjunto de dados de treinamento/validação.
- A construção downstream dos índices combina diferentes modelos de alocação de ativos em índices de diferentes tipos. Esse processo baseia-se em um método fixo, com foco em obter um risco diversificado em toda a carteira, e não no desempenho dos ativos. No entanto, esta etapa inclui escolhas de parâmetros e a seleção dos ativos do índice, em que se deve evitar a introdução de um viés de seleção.
Princípios de mitigação
Para reduzir o impacto do overfitting, uma série de princípios é rigorosamente seguida.
Cabe observar, no entanto, que todas as abordagens têm limitações e que é necessária cautela em relação a todas as decisões.
Princípios seguidos
- Todos os dados das variáveis devem estar disponíveis em um futuro previsível e, assim como as definições das variáveis, não sofrem alterações depois que o modelo do ativo é congelado. As escolhas de dados e de definição das variáveis baseiam-se no conhecimento de domínio obtido na prática da negociação fundamentalista/discricionária de commodities, que poderia ser revisto ao longo do tempo. No entanto, dado o foco em fatores estacionários, o princípio adotado é congelar também os aspectos relativos aos dados, para evitar um possível overfitting por meio desse processo de revisão/atualização.
- O treinamento e a seleção dos modelos dos ativos baseiam-se estritamente em dados disponíveis até o fim de 2016, o que também coincide com o período após o qual os modelos de alocação da maioria das commodities líquidas foram congelados e passaram a estar disponíveis em negociação real. Por esse motivo, o período também é usado para treinamento/validação de novas pesquisas e de novos modelos de ativos.
- Otimizar os parâmetros dentro da amostra no método final de alocação de ativos poderia, potencialmente, gerar um viés de seleção. No entanto, a faixa de valores é limitada, de modo que não se espera um impacto dramático sobre os resultados, e os resultados são validados pela ausência de overfitting significativo nos resultados fora da amostra.
- O teste de todo o modelo upstream de alocação de ativos exige que todos os detalhes sejam congelados antes de se obterem os resultados de teste fora da amostra, com dados de reserva (hold-out) a partir de 1 Jan 2017. A prática rigorosa de congelar o método e usar os conjuntos de dados de reserva para a avaliação upstream final, comum na comunidade de ML, foi escolhida como a principal medida para reduzir o risco de subestimar o impacto de um efeito lisonjeiro sobre os resultados decorrente de um viés de testes múltiplos, e/ou de incluí-lo acidentalmente. Pelo mesmo motivo, a maioria dos modelos de alocação de ativos líquidos foi congelada a partir de 1 Jan 2017 e não foi alterada desde então, ou seja, gerando resultados fora da amostra em tempo real.
- A construção downstream dos índices envolve parâmetros que, em sua maioria, têm impacto modesto sobre o desempenho, como a meta de volatilidade e os limites de alocação, entre outros, e as decisões geralmente se baseiam em objetivos práticos, e não no desempenho do índice. No entanto, é preciso ter cuidado, em especial em relação à seleção dos ativos do índice, que tem maior influência sobre o desempenho. Aqui, o princípio geral é considerar os ativos em base equivalente e só introduzir distinções entre ativos se isso for motivado no estágio de treinamento e respaldado pelos resultados dos testes fora da amostra.