
过拟合分析
译自英文。以英文原文为准。 阅读英文版
过拟合风险
概述
- 与所有系统化交易策略一样,AiLA 策略也面临基于过拟合结果的风险。
- 即使出于最佳意图并遵循现行最佳实践,也无法保证避免过拟合,例如无意中受到过往经验的影响。
- 为积极尽量降低过拟合的影响,AiLA 的策略开发严格遵循一套原则。
纲要
- 类型:针对策略研发的不同步骤,总结常见的过拟合来源。
- 风险:重点说明 AiLA 策略流程中存在过拟合风险的主要步骤。
- 缓解:说明 AiLA 为降低过拟合风险所遵循的原则。
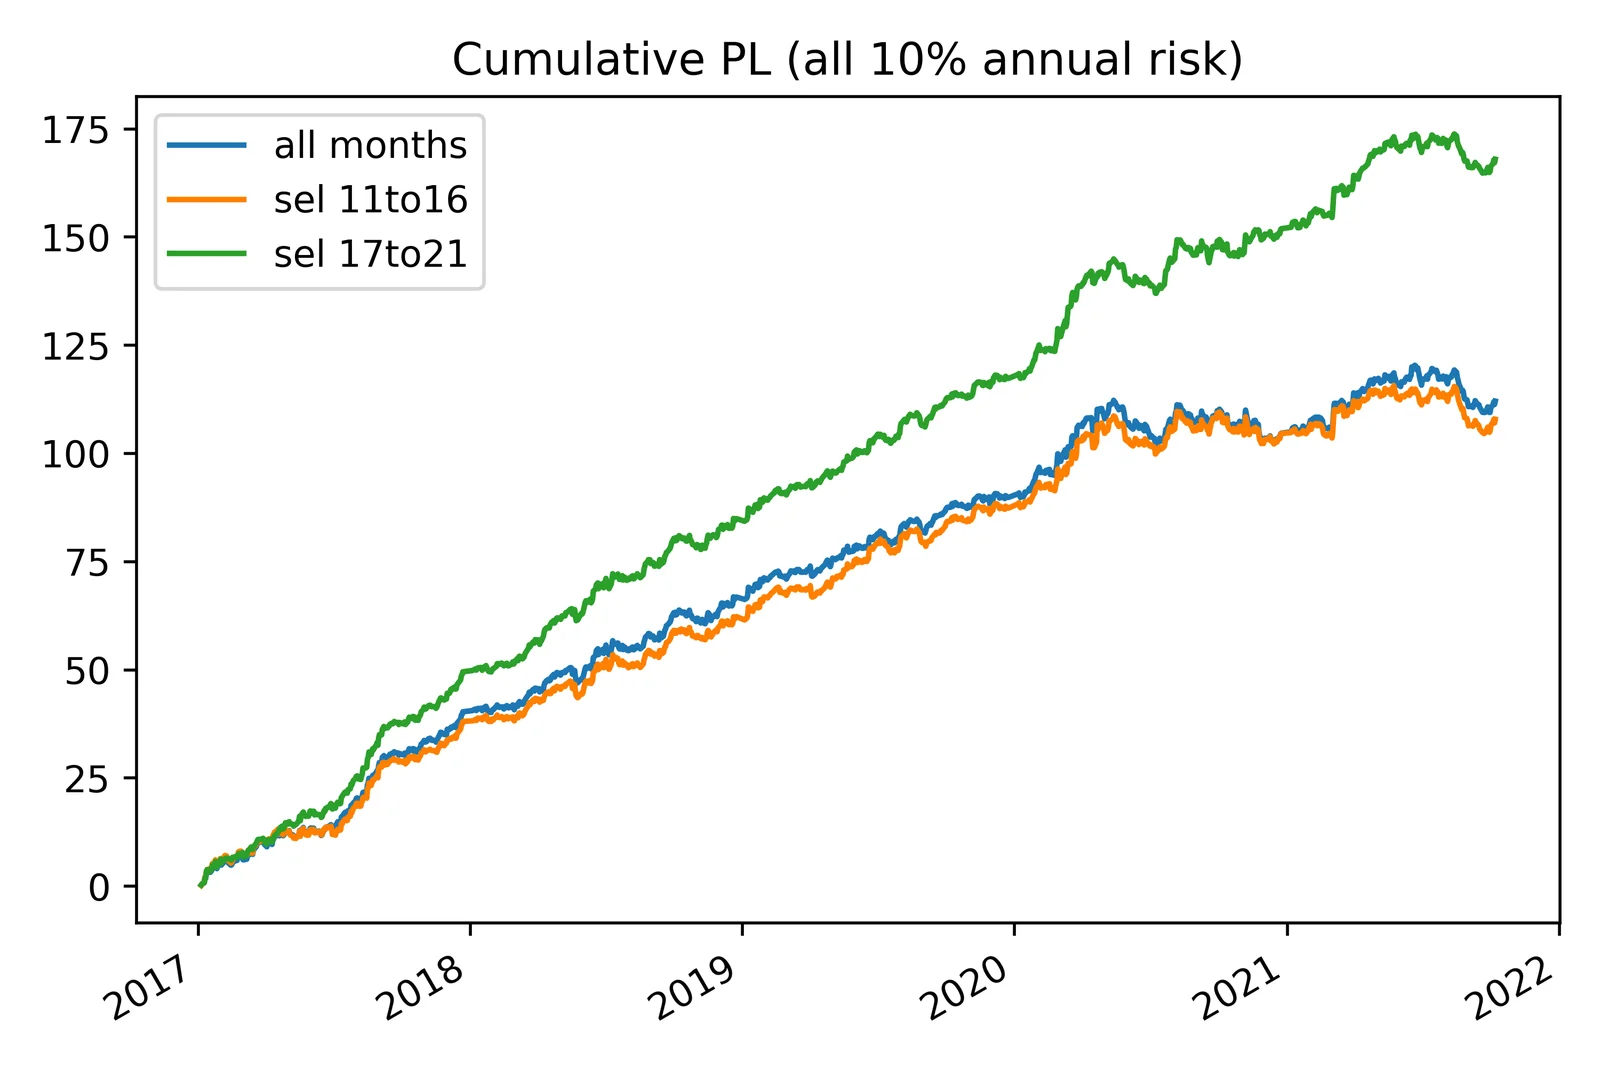
- 过拟合策略结果示意图,详情参见观点文章 [Overfitting Risk]。
- 策略改进方案使用与评估相同的数据进行设计,其表现优于默认策略(2017 年至 2021 年)。
- 基于不同数据(2011 年至 2016 年)的同一改进策略显示,该假设并无影响。
过拟合的类型
过拟合通常在研发过程的不同阶段加以考量,以下为两种常见类型。
该术语在机器学习(ML)领域中十分常见,但这些问题并非 ML 所特有,而适用于任何借助数据开展的工作。
训练(设计)阶段
- 指在策略训练或设计阶段发生的过拟合。
- 在此阶段,过拟合在一定程度上不可避免,需采用不同方法来应对将某种关系拟合到样本内数据噪声上所带来的问题。
测试阶段
- 指在策略测试阶段发生的过拟合,而该阶段本不应出现任何过拟合。
- 这通常源于多重测试情形,例如“测试多个并挑选最佳”或“测试、修改后再测试”,而导致结果被美化的原因在最终评估中被忽视(通常是无意的)。
应对过拟合的措施示例
训练(设计)阶段
- 采用交叉验证技术,检验结果在样本外数据中的可复现(泛化)能力。
- 采用正则化技术,降低模型复杂度以及对特定数据样本的敏感性。
- 可使用集成模型降低模型结果的方差,使其在过拟合方面更加稳健。
测试阶段
- 记录所进行的多重测试,并采用相应方法校正或估计其影响,例如族系检验(familywise tests)或缩减后的表现(deflated performance)。
- 严格执行关于预先登记测试细节以及使用不同(“盲测”)数据的政策。
上文示意图 [Overfitting Risk] 中的过拟合可通过交叉验证轻易发现,但测试过程中(无意)发生的过拟合通常更难量化。
风险领域
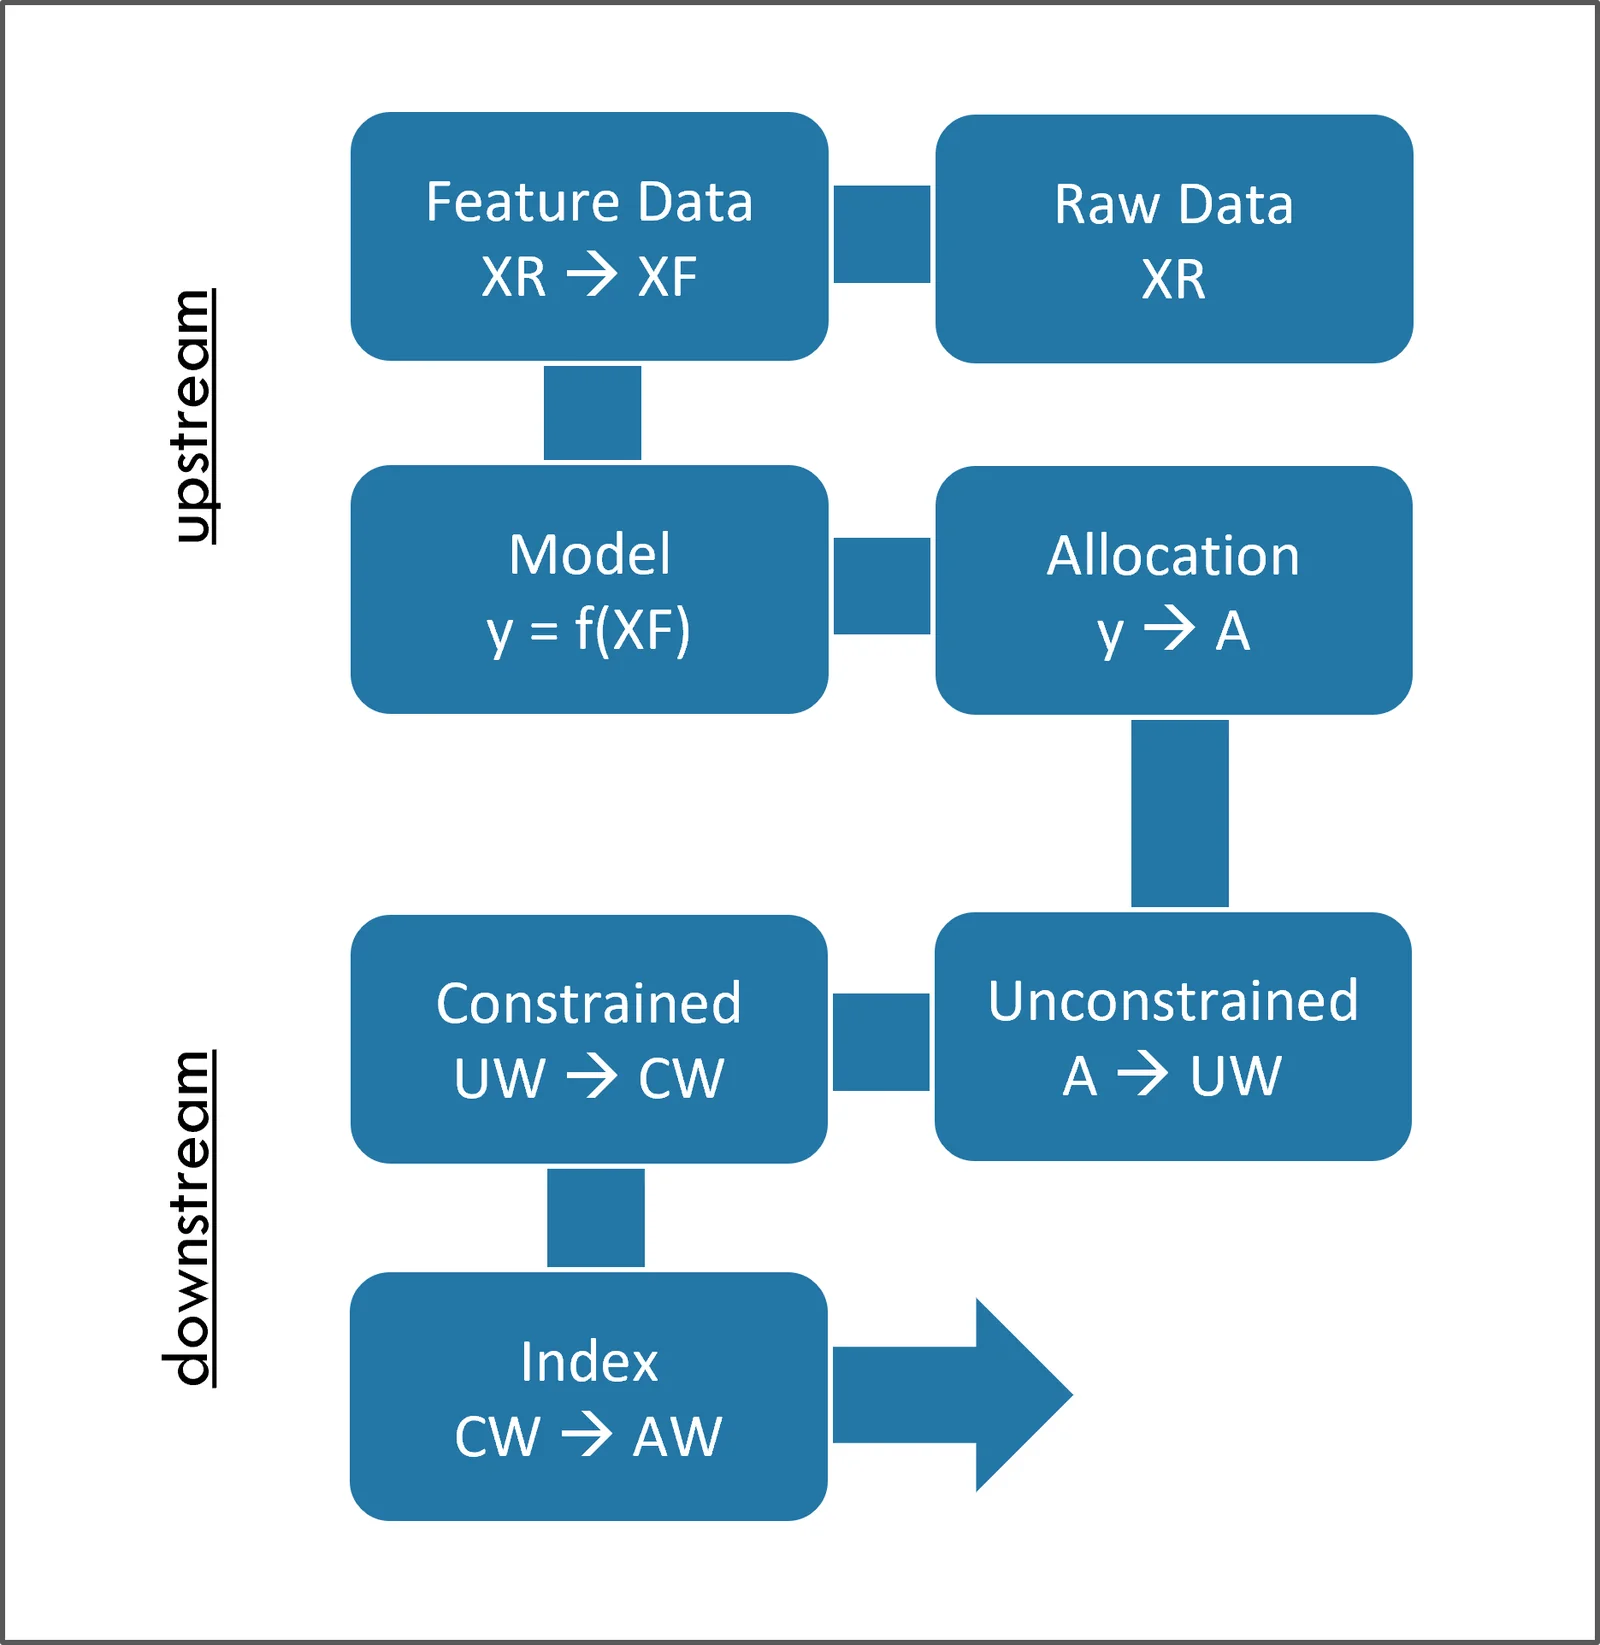
在 AiLA 策略开发的整个过程中,存在多个可能发生过拟合的环节。
风险尤为突出的领域
- 关于微观/宏观数据及特征定义的选择,这涉及如何最好地让数据揭示重要因子,而不预设策略应如何使用这些数据。
- 资产模型的训练与选择。在此环节,采用上述技术应对过拟合,所有模型评估和超参数调优均使用预先确定的训练/验证数据集进行。
- 最终的上游配置方法同样使用相同的训练/验证数据集对其参数进行优化。
- 下游指数构建将不同的资产配置模型组合成不同类型的指数。这一过程基于固定方法,重点在于实现投资组合风险的分散化,而非资产表现。但该步骤涉及参数选择和指数资产选择,必须避免引入选择偏差。
缓解原则
为降低过拟合的影响,我们严格遵循一系列原则。
但需要指出的是,所有方法都有不足之处,因此对所有决策都需保持审慎。
所遵循的原则
- 所有特征数据在可预见的未来都应可获取;资产模型冻结后,数据及特征定义均不作任何更改。数据和特征定义的选择基于从事基本面/主观大宗商品交易所获得的领域知识,这些知识可能会随时间推移而重新审视。然而,鉴于重点在于平稳因子,所采用的原则是同样冻结数据相关方面,以避免通过此类审视/更新过程产生潜在的过拟合。
- 资产模型的训练和选择严格基于截至 2016 年底的可用数据,这也与大多数高流动性大宗商品的资产配置模型被冻结并投入实盘交易的时点相吻合。因此,该时期也用于新研究和新资产模型的训练/验证。
- 在样本内优化最终资产配置方法的参数可能导致选择偏差。不过,参数取值范围有界,预计不会对结果产生剧烈影响;且样本外结果中未观察到显著的过拟合,也验证了这些结果。
- 测试整个上游资产配置模型时,要求在使用自 1 Jan 2017 起的保留数据获得样本外测试结果之前,冻结所有细节。冻结方法并使用保留数据集进行最终上游评估的严格做法(这在 ML 领域十分常见)被选为主要措施,以降低以下风险:低估多重测试偏差对结果的美化效应和/或意外引入此类效应。出于同样原因,大多数高流动性资产配置模型自 1 Jan 2017 起即被冻结,此后未作更改,从而产生实盘样本外结果。
- 下游指数构建涉及的参数大多对表现影响有限,例如波动率目标和配置上限等,相关决策通常基于实际目标而非指数表现。但仍须谨慎,尤其是对表现影响较大的指数资产选择。此处的总体原则是以同等标准考虑各资产,仅当在训练阶段有充分理由且得到样本外测试结果的支持时,才对资产进行区别对待。