
過学習の分析
英語からの翻訳です。英語の原文を正とします。 英語で読む
過学習のリスク
概要
- すべてのシステマティック・トレーディング戦略と同様に、AiLA の戦略も過学習した結果に基づいてしまうリスクを抱えています。
- 最善の意図を持ち、現時点で最善とされる手法に従ったとしても、過学習を回避できる保証はありません。例えば、過去の経験に意図せず影響を受けることがあります。
- 過学習の影響を積極的に最小化するため、AiLA の戦略開発は一連の原則に厳格に従っています。
構成
- 種類:戦略の研究開発の各ステップに関して、一般に考慮される過学習の発生源をまとめます。
- リスク:AiLA の戦略プロセスのうち、過学習が生じるリスクのある主なステップを示します。
- 軽減策:過学習のリスクを低減するために AiLA が従っている原則を説明します。
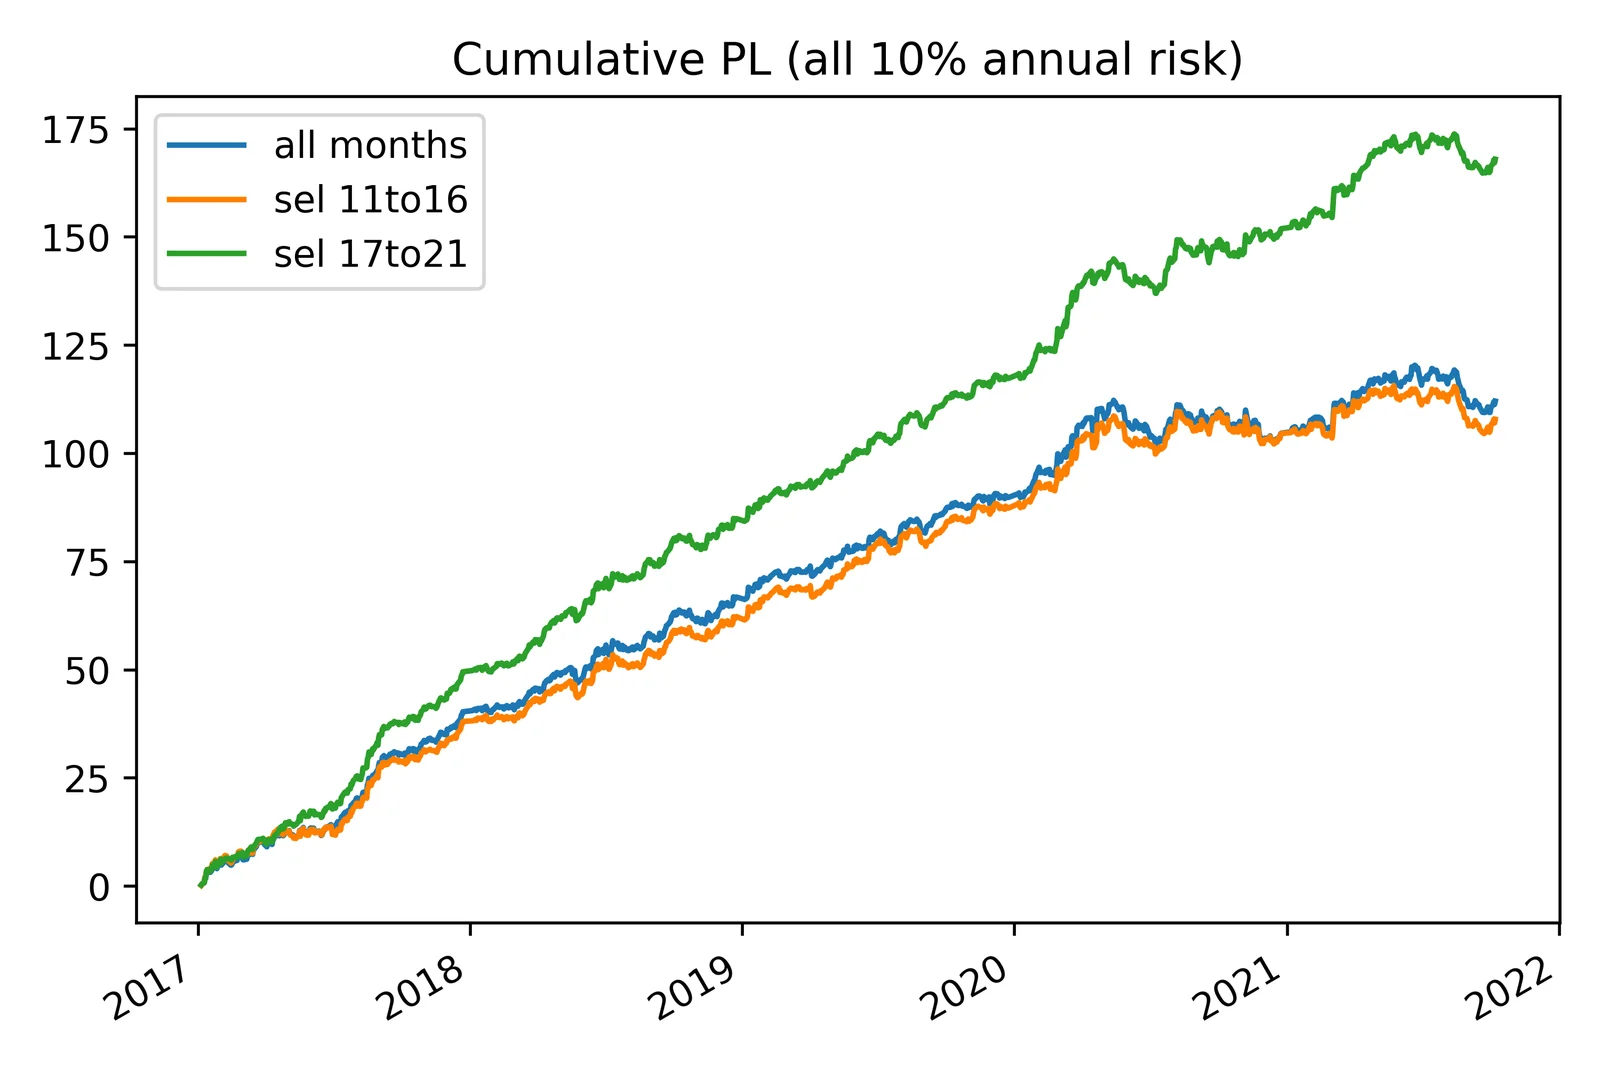
- 過学習した戦略結果の例です。詳細は Perspective [Overfitting Risk] を参照してください。
- 戦略の改良を、パフォーマンスの向上を評価するのと同じデータを用いて設計し、デフォルト戦略と比較した結果(2017 年~2021 年)。
- 同じ改良戦略を別のデータ(2011 年~2016 年)で評価すると、仮説には効果がないことが示されます。
過学習の種類
過学習は、研究開発プロセスのさまざまな段階で考慮されることが多く、代表的な 2 つの種類を以下に示します。
この用語は機械学習(ML)で一般的に用いられますが、問題は ML に固有のものではなく、データを参照するあらゆる作業に当てはまります。
学習(設計)段階
- 戦略の学習または設計の段階で生じる過学習を指します。
- この段階での過学習はある程度避けられず、インサンプル・データのノイズに関係を当てはめてしまうことから生じる問題に対処するため、さまざまな手法が用いられます。
テスト段階
- 過学習を意図していない戦略のテスト段階で生じる過学習を指します。
- これは多くの場合、「多数をテストして最良のものを選ぶ」や「テストし、変更して再度テストする」といった複数回のテストのシナリオから生じ、結果を見栄え良くしている原因が最終評価で(多くの場合意図せず)見落とされます。
過学習に対処する方策の例
学習(設計)段階
- アウトオブサンプル・データで結果を再現(汎化)できるかを確認するため、交差検証の手法を用います。
- モデルの複雑さと特定のデータ標本への感応度を下げるため、正則化の手法を用います。
- アンサンブル・モデルを用いてモデル結果の分散を小さくし、過学習に対してより頑健にすることができます。
テスト段階
- 実施した複数のテストを記録し、ファミリーワイズ検定やデフレーテッド・パフォーマンスなど、影響を補正または推定する手法を用います。
- テストの詳細の事前登録と、別の(「ブラインド」の)データの使用について、厳格な方針を徹底します。
上記の例 [Overfitting Risk] は交差検証で容易に明らかになりましたが、テスト中に(意図せず)生じる過学習は、通常、定量化がはるかに困難です。
リスク領域
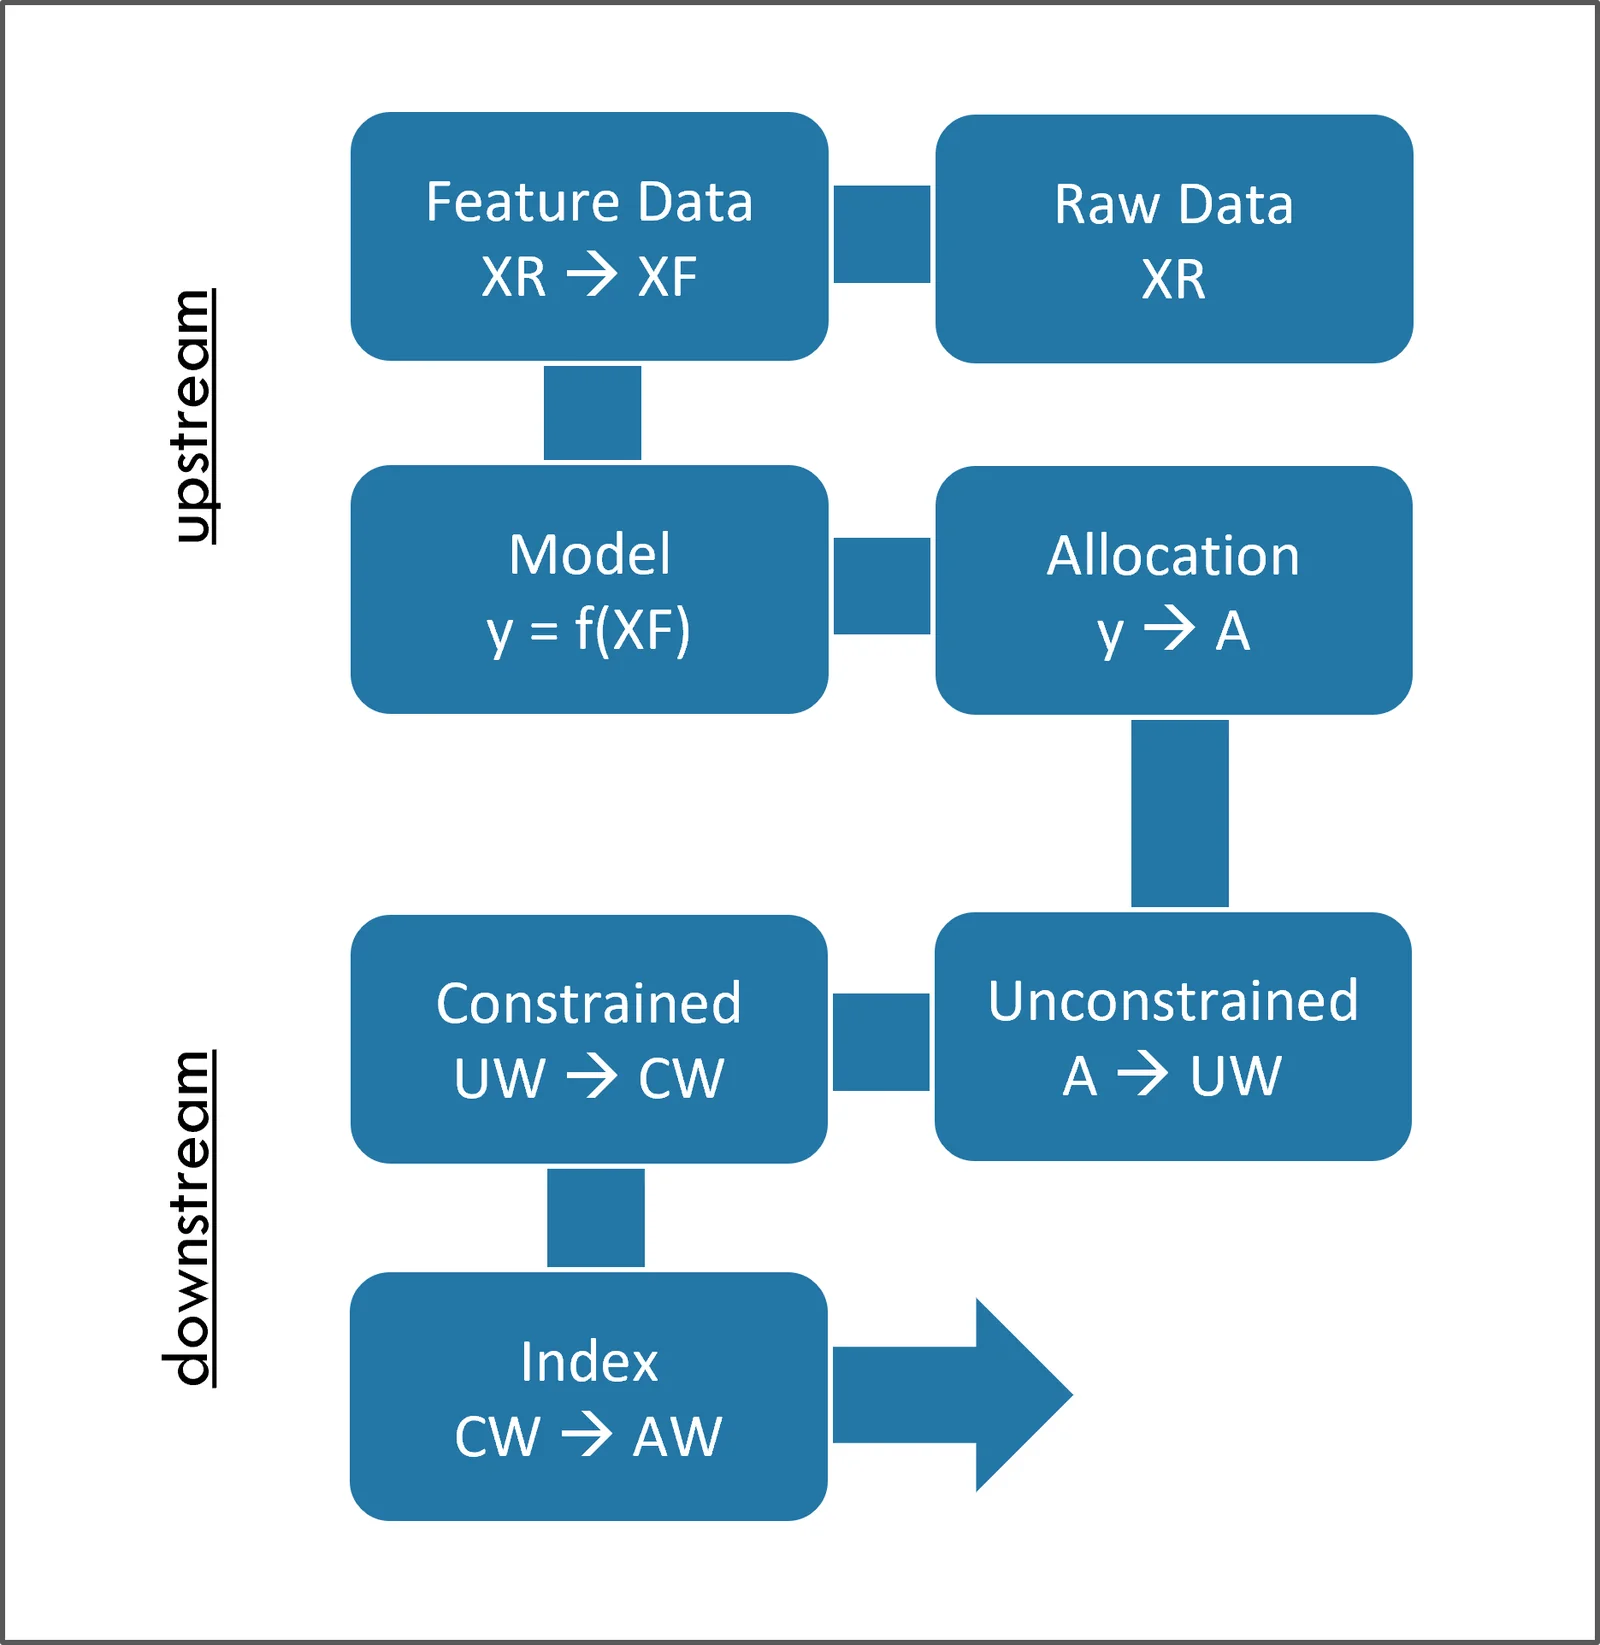
AiLA の戦略開発プロセス全体を通じて、過学習が生じ得る場面がいくつかあります。
特にリスクのある領域
- ミクロ/マクロ・データと特徴量の定義に関する選択です。これは、データを戦略でどのように用いるべきかを示唆することなく、重要なファクターをデータからいかに最善に浮かび上がらせるかに関わります。
- 資産モデルの学習と選択です。ここでは前述のような手法を用いて過学習に対処し、モデルの評価とハイパーパラメータの調整はすべて、あらかじめ定めた学習/検証データセットを用いて行います。
- 最終的な上流のアロケーション手法も、同じ学習/検証データセットを用いて、そのパラメータに関して最適化します。
- 下流の指数構築では、異なるアセット・アロケーション・モデルを組み合わせて、さまざまな種類の指数を作ります。このプロセスは固定された手法に基づき、資産のパフォーマンスよりも、ポートフォリオ全体でリスクを分散させることに重点を置いています。ただし、このステップにはパラメータの選択と指数の構成資産の選定が含まれ、そこでは選択バイアスの導入を避けなければなりません。
軽減の原則
過学習の影響を低減するため、いくつかの原則を厳格に守っています。
ただし、どのアプローチにも欠点があり、あらゆる判断に注意が必要である点に留意すべきです。
遵守している原則
- すべての特徴量データは予見可能な将来にわたって利用可能であるべきであり、資産モデルを凍結した後は、特徴量の定義とともに一切変更しません。データと特徴量の定義の選択は、ファンダメンタル/裁量型のコモディティ・トレーディングの実務から得たドメイン知識に基づいており、時間とともに見直される可能性もあります。しかし、定常的なファクターに重点を置いていることから、こうした見直し/更新のプロセスを通じた過学習の可能性を避けるため、データの側面も凍結することを原則としています。
- 資産モデルの学習と選択は、厳格に 2016 年末までに利用可能なデータのみに基づいて行います。これは、流動性の高いコモディティの大半についてアセット・アロケーション・モデルが凍結され、実運用で利用可能となった時期とも一致します。このため、この期間は新たな研究や資産モデルの学習/検証にも用いられます。
- 最終的なアセット・アロケーション手法のパラメータをインサンプルで最適化すると、選択バイアスが生じる可能性があります。ただし、値の範囲には上下限が設けられているため、結果に劇的な影響を与えることは想定されず、アウトオブサンプルの結果に有意な過学習が見られないことで、結果の妥当性を確認しています。
- 上流のアセット・アロケーション・モデル全体のテストでは、2017 年 1 月 1 日以降のホールドアウト・データを用いてアウトオブサンプルのテスト結果を得る前に、すべての詳細を凍結することを求めています。手法の凍結と、上流の最終評価へのホールドアウト・データセットの使用に関する厳格な運用は、ML のコミュニティで一般的なものであり、複数回のテストによるバイアスが結果を見栄え良くする効果について、その影響の過小評価や意図しない混入のリスクを低減する主な方策として選んでいます。同じ理由から、流動性の高い資産のアロケーション・モデルの大半は 2017 年 1 月 1 日から凍結され、それ以降変更されていません。つまり、実運用のアウトオブサンプル結果が得られています。
- 下流の指数構築には、ボラティリティ目標やアロケーションの上限など、主にパフォーマンスへの影響が穏当なパラメータが含まれ、その決定は概して指数のパフォーマンスではなく実務上の目的に基づいています。ただし注意は必要であり、特にパフォーマンスへの影響がより大きい指数の構成資産の選定には注意を要します。ここでの一般原則は、資産を同等の基準で扱い、学習段階で根拠があり、かつアウトオブサンプルのテスト結果で裏付けられる場合にのみ、資産間に差を設けることです。