Modelización de señales CTA
Traducido del inglés. El texto en inglés es la referencia. Leer en inglés
Preguntas
¿Podemos crear un modelo de aprendizaje supervisado para una estrategia CTA con los enfoques siguientes?
- División cronológica de los datos
- Para evitar la fuga de datos y simular un backtesting adecuado
- Sobremuestreo aleatorio (no sintético)
- Para tratar el desequilibrio de clases
- Modelización con transformación de variables mediante algoritmos de conjuntos de árboles
Principales datos de entrada de la tarea:
- Fechas
- Inicio de la validación
- Inicio del periodo de reserva (holdout)
- Fin del periodo de reserva
- Métrica de optimización (Accuracy, Precision, Recall, F1, Neg Log Loss)
- Frecuencia de entrenamiento (año, trimestre, mes, día)
Resultados:
- Señales predichas, largas o cortas
- Métricas agregadas de validación frente a reserva
- Matrices de confusión de validación frente a reserva
- Hiperparámetros definitivos del modelo
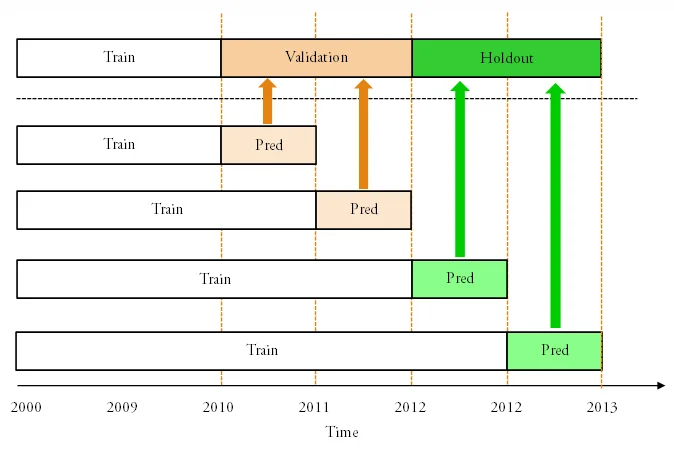
División cronológica de los datos
- División cronológica de los datos en conjuntos de entrenamiento/validación/reserva
- Se supone un backtesting con un intervalo fijo de reentrenamiento del modelo:
- anual
- trimestral
- mensual
- diario
- Periodo de validación:
- Las predicciones de este periodo se puntúan y se utilizan para ajustar los hiperparámetros
- Periodo de reserva:
- Las predicciones de este periodo se registran, pero no se utilizan para ningún ajuste
Sobremuestreo aleatorio (no sintético)
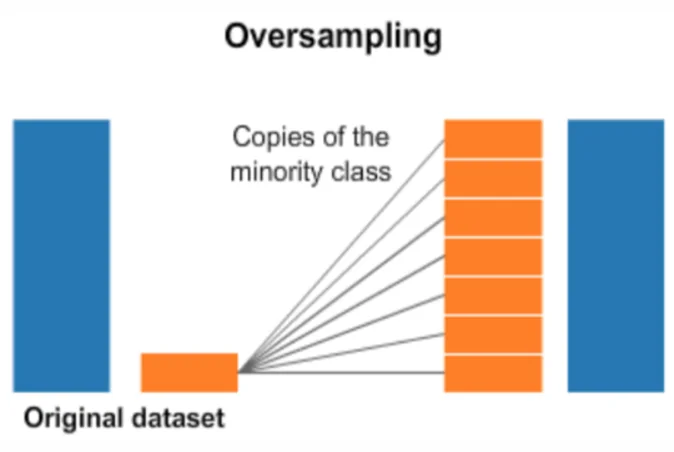
- La modelización de señales es un problema de clasificación binaria
- Las señales de los activos CTA suelen estar muy desequilibradas (una proporción de alrededor de 1:4)
- Aplicar directamente un modelo de ML daría lugar a que la mayoría de las veces se predijera la clase mayoritaria
- Enfoque
- Se realiza un sobremuestreo aleatorio no sintético de la clase minoritaria hasta una proporción de 1:1
- El sobremuestreo se implementa con una semilla aleatoria reproducible
Metodología de modelización
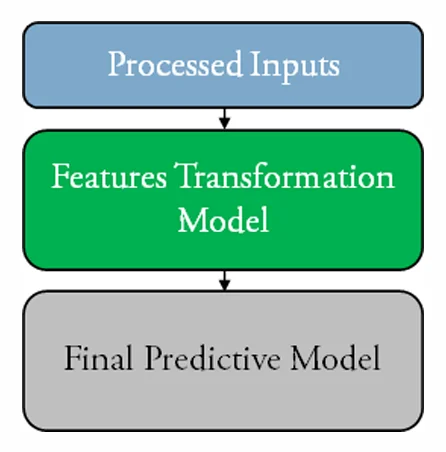
Marco del modelo
- Datos de entrada -> modelo de conjunto de árboles para la transformación de variables (FT) -> codificación one-hot -> modelo predictivo final
Modelo de conjunto de árboles FT:
- Se utiliza un algoritmo supervisado de conjunto de árboles para transformar las variables
- Enfoque:
- Se entrena primero con los datos de entrenamiento (y nunca se expone a los datos de prueba)
- Después se utiliza como paso de transformación de variables, en el que:
- los datos preprocesados se introducen en el modelo
- las hojas de cada árbol se utilizan como variables de entrada del modelo siguiente
- Ayuda a captar relaciones no lineales en los datos y actúa a la vez como una forma de regularización
Modelo predictivo final:
- Algoritmo de árboles con gradient boosting de última generación
- Recibe los datos con las variables transformadas y codificadas one-hot de la capa anterior y realiza una predicción de clasificación binaria
Proceso de modelización CTA
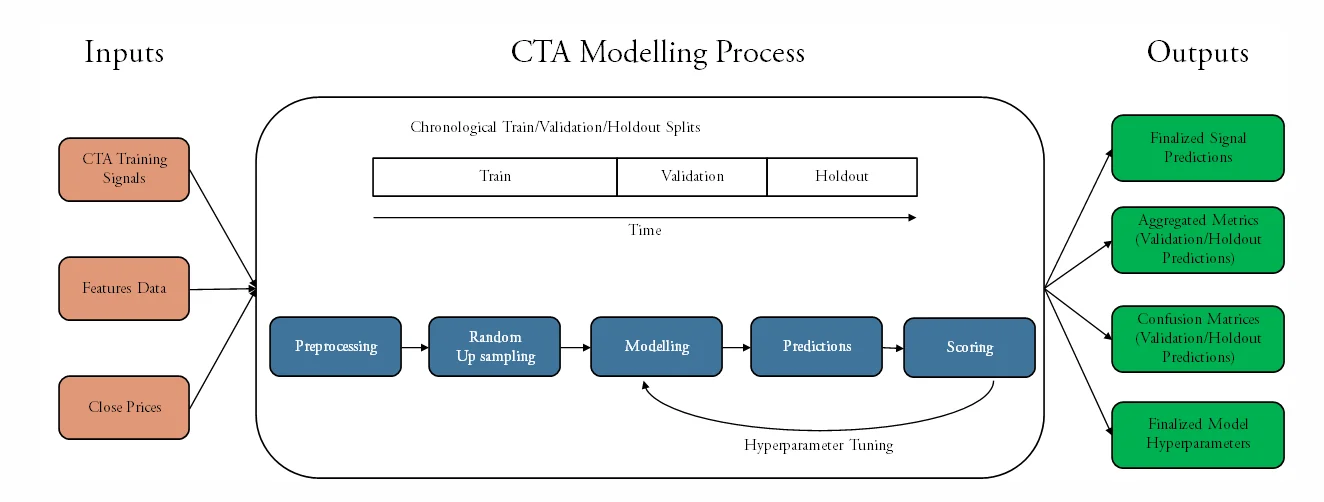
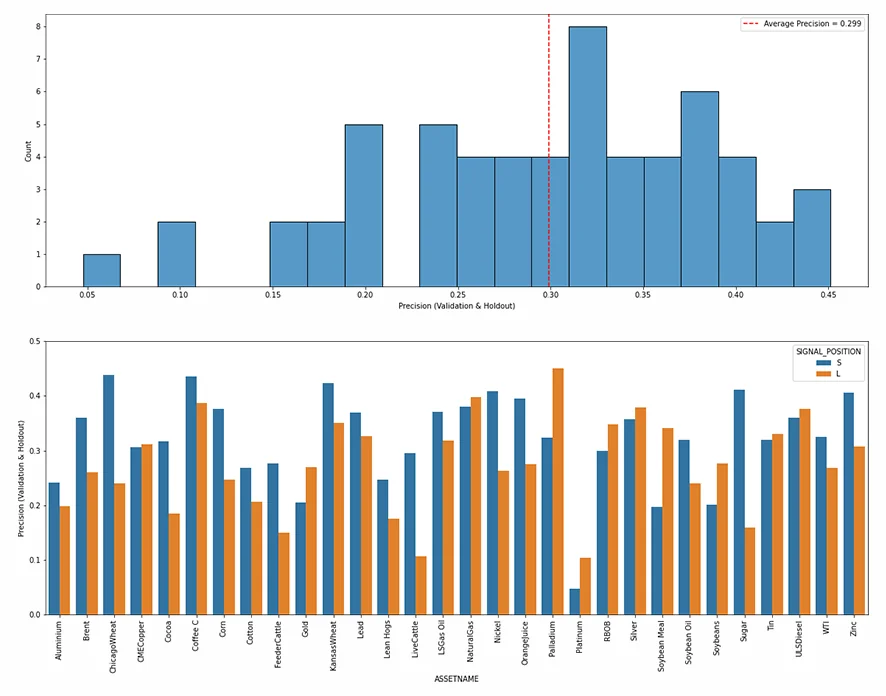
Gráficos de precisión
Precisión = (verdaderos positivos)/(positivos predichos) para el conjunto de las predicciones de los periodos de validación y de reserva, para cada posición de señal (larga/corta)
Gráfico 1: histograma de la precisión:
- 30 activos x 2 posiciones de señal = 60
- Media = 0.299
- La moda se sitúa entre 0.30 y 0.35
Gráfico 2: gráfico de barras de la precisión por activo
- Cada activo tiene dos valores de precisión (uno por cada posición de señal)
- La mayoría de los activos tienen resultados de precisión similares para ambas posiciones de señal