Modélisation des signaux CTA
Traduit de l’anglais. Le texte anglais fait foi. Lire en anglais
Questions
Peut-on créer un modèle d’apprentissage supervisé pour une stratégie CTA à l’aide des approches ci-dessous ?
- Découpage chronologique des données
- Pour éviter les fuites de données et simuler un backtest rigoureux
- Suréchantillonnage aléatoire (non synthétique)
- Pour traiter le déséquilibre des classes
- Modélisation avec transformation des variables par des algorithmes d’ensembles d’arbres
Principaux paramètres d’entrée :
- Dates
- Début de la validation
- Début de la période réservée (holdout)
- Fin de la période réservée (holdout)
- Métrique d’optimisation (exactitude [Accuracy], précision [Precision], rappel [Recall], F1, log-perte négative [Neg Log Loss])
- Fréquence d’entraînement (année, trimestre, mois, jour)
Résultats :
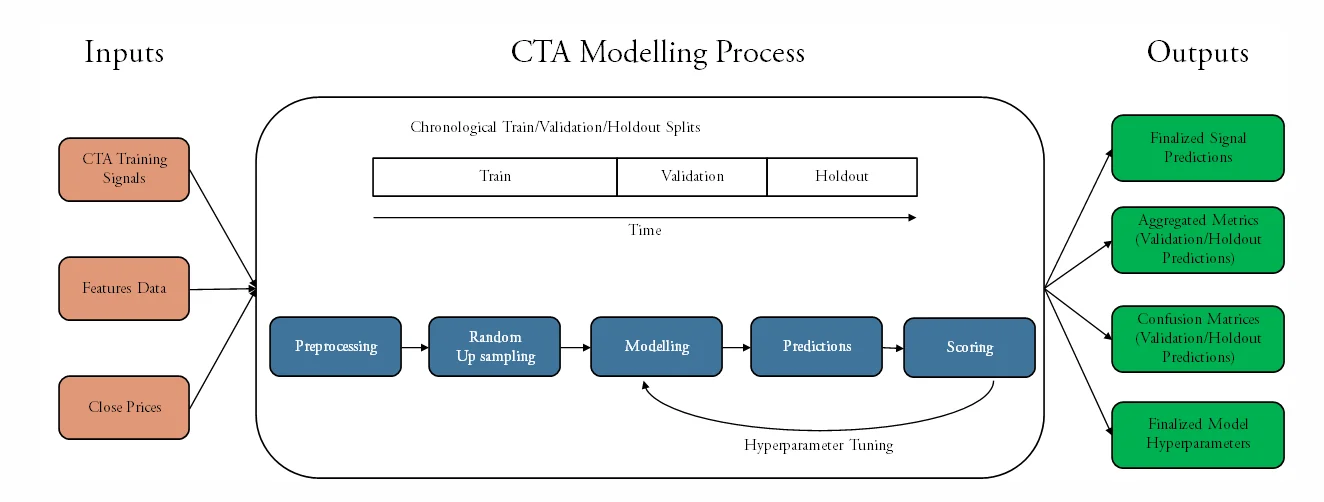
- Signaux prédits, longs ou courts
- Métriques agrégées pour la validation et la période réservée
- Matrices de confusion pour la validation et la période réservée
- Hyperparamètres finaux du modèle
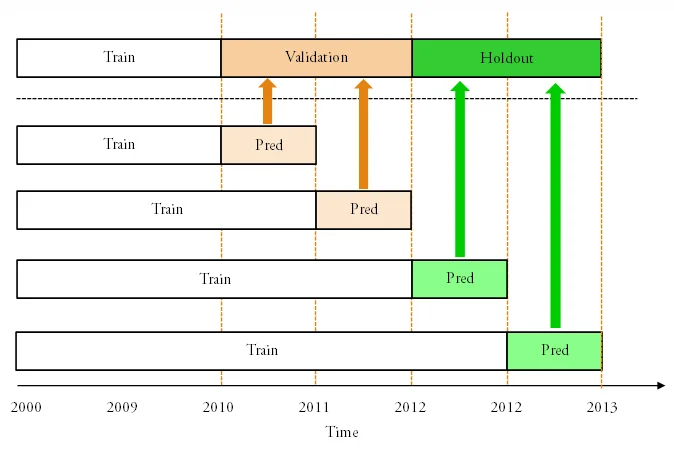
Découpage chronologique des données
- Découpage chronologique des données en échantillons d’entraînement, de validation et réservé (holdout)
- Suppose un backtest avec un intervalle fixe de réentraînement du modèle
- Annuel
- Trimestriel
- Mensuel
- Quotidien
- Période de validation :
- Les prédictions de cette période sont évaluées et servent au réglage des hyperparamètres
- Période réservée (holdout) :
- Les prédictions de cette période sont enregistrées mais ne servent à aucun réglage
Suréchantillonnage aléatoire (non synthétique)
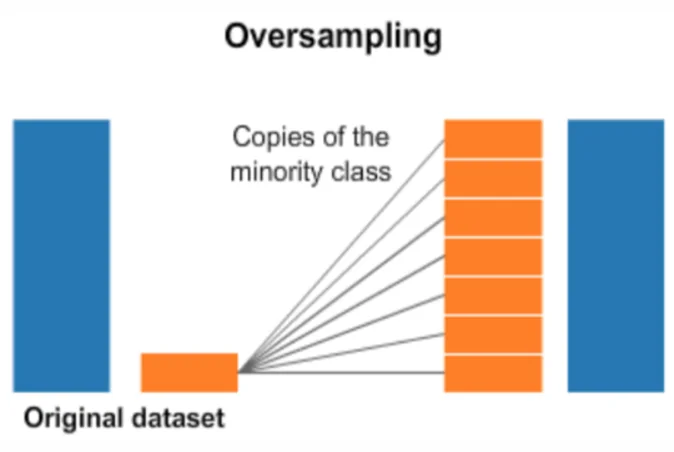
- La modélisation des signaux est un problème de classification binaire
- Les signaux des actifs CTA tendent à être très déséquilibrés (ratio d’environ 1:4)
- Appliquer directement un modèle de ML conduirait à prédire la classe majoritaire la plupart du temps
- Démarche
- La classe minoritaire fait l’objet d’un suréchantillonnage aléatoire non synthétique jusqu’à un ratio de 1:1
- Le suréchantillonnage est mis en œuvre avec une graine aléatoire reproductible
Méthodologie de modélisation
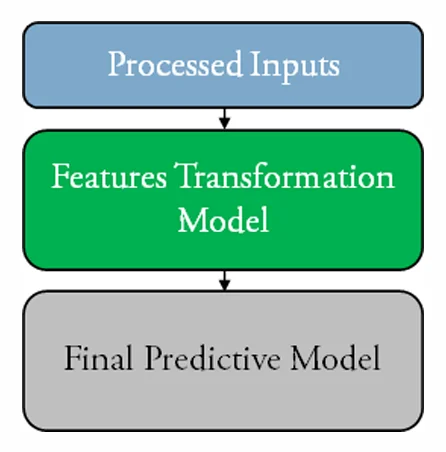
Architecture du modèle
- Entrées -> modèle d’ensembles d’arbres de transformation des variables (FT, Feature Transformation) -> encodage one-hot -> modèle prédictif final
Modèle d’ensembles d’arbres FT :
- Utilise un algorithme d’ensembles d’arbres en apprentissage supervisé pour la transformation des variables
- Démarche :
- Il est d’abord entraîné sur les données d’entraînement (et n’est jamais exposé aux données de test)
- Il sert ensuite d’étape de transformation des variables, dans laquelle :
- les données prétraitées sont fournies au modèle ;
- les feuilles de chaque arbre servent de variables d’entrée au modèle suivant.
- Il aide à capter les relations non linéaires dans les données tout en jouant un rôle de régularisation
Modèle prédictif final :
- Algorithme de pointe d’arbres à gradient boosting
- Il reçoit les données transformées et encodées en one-hot de la couche précédente et effectue une prédiction de classification binaire
Processus de modélisation CTA
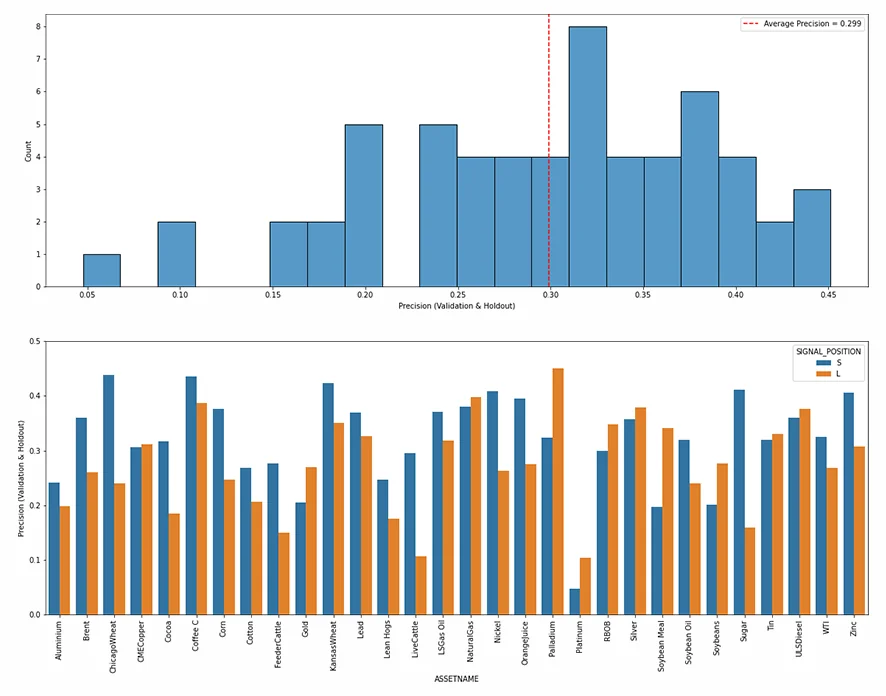
Graphiques de précision
Précision = (vrais positifs)/(positifs prédits) pour l’ensemble des prédictions des périodes de validation et réservée, pour chaque sens de signal (long/short)
Graphique 1 : histogramme de la précision :
- 30 actifs x 2 sens de signal = 60
- Moyenne = 0.299
- Le mode se situe entre 0.30 et 0.35
Graphique 2 : diagramme en barres de la précision par actif
- Chaque actif a deux valeurs de précision (une par sens de signal)
- La plupart des actifs affichent des précisions similaires pour les deux sens de signal