
特徵轉換:集成樹與 SVM 之比較
本頁譯自英文,內容以英文版本為準。 閱讀英文版
問題
問題:
- AiLA 的 CML 策略採用以分類為基礎的特徵轉換步驟,旨在協助處理非線性關係,並對可能數量龐大的特徵發揮正則化作用[詳情請參閱 CML 建模章節]。
- 特徵轉換的效益為何?
- 若以 SVM(支援向量機)取代集成樹方法,會有什麼結果?
研究方法:
- 以模型精確率及被判定為正類的天數作為與策略績效相關的指標。
- 使用相同的資料樣本與架構設定進行對照比較,唯一差異在於特徵轉換步驟。
精確率超額表現:
- 樣本中由 CML 策略預測為真實標籤的比例,減去整體資料樣本中的該比例。
- 多數資產的真實樣本比例較高,且驗證資料與保留資料的結果一致。
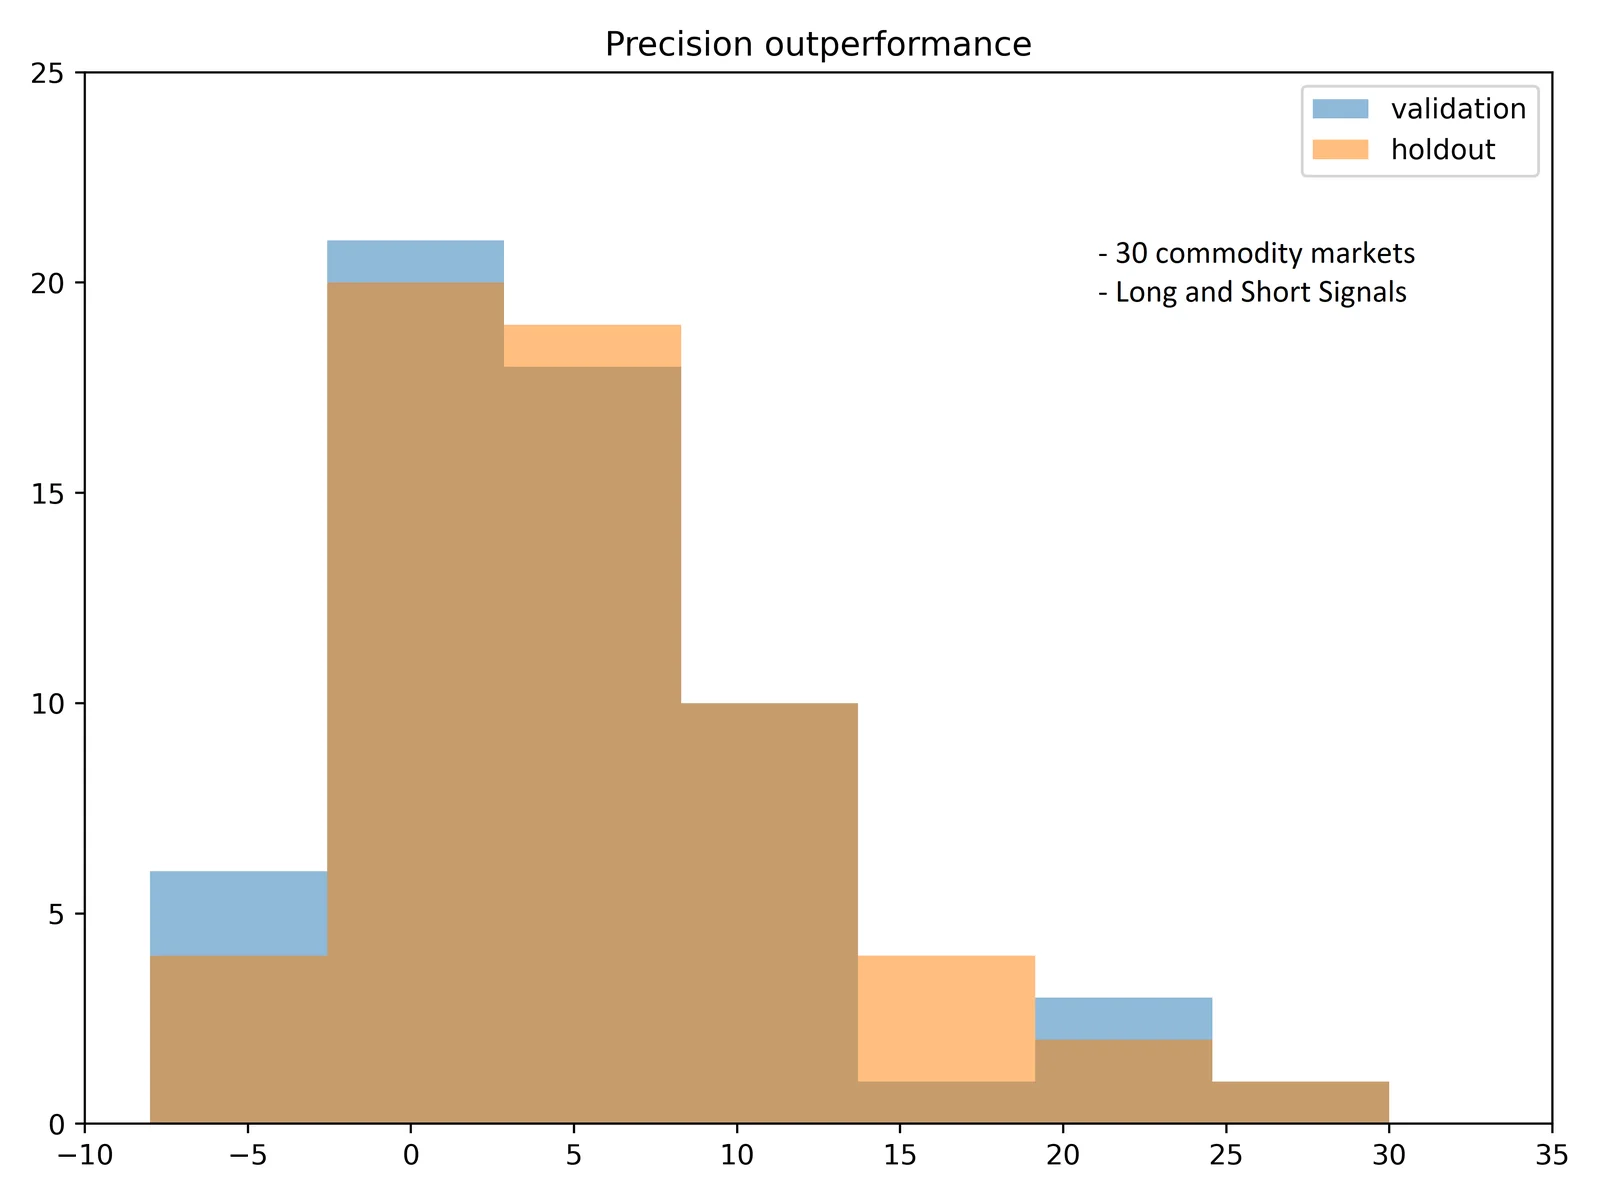
一致性檢驗
- 本研究與[CML 建模章節]的分析略有差異,例如納入 2021 年資料並使用一組固定的超參數。
- 然而,在存在這些細微差異的情況下,預測結果之間大致具有良好的一致性。
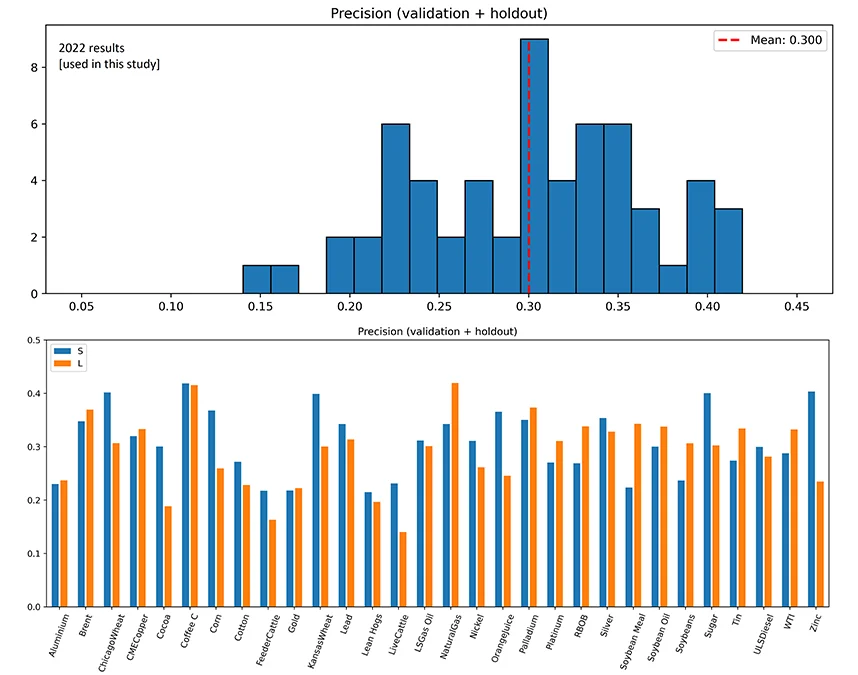
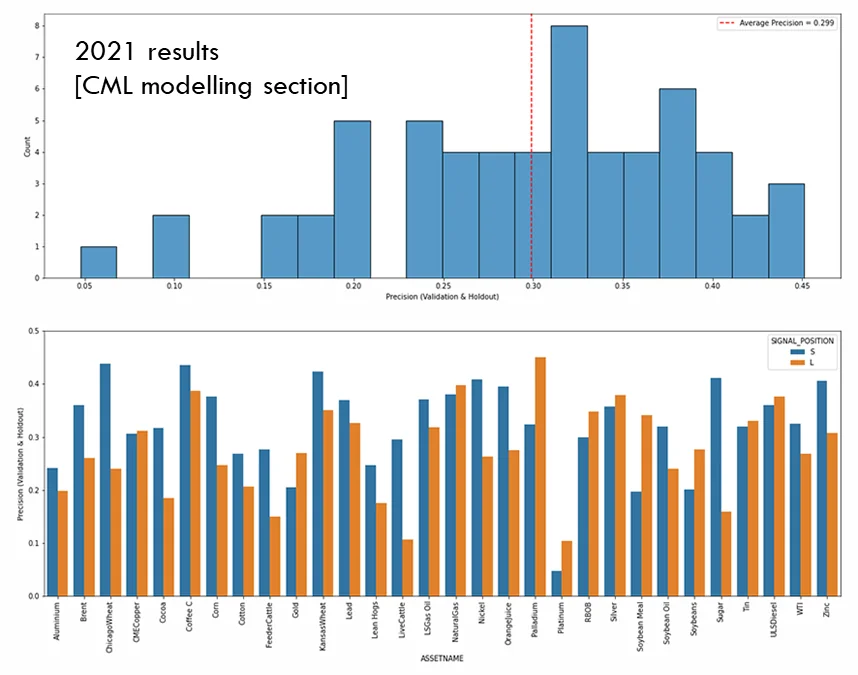
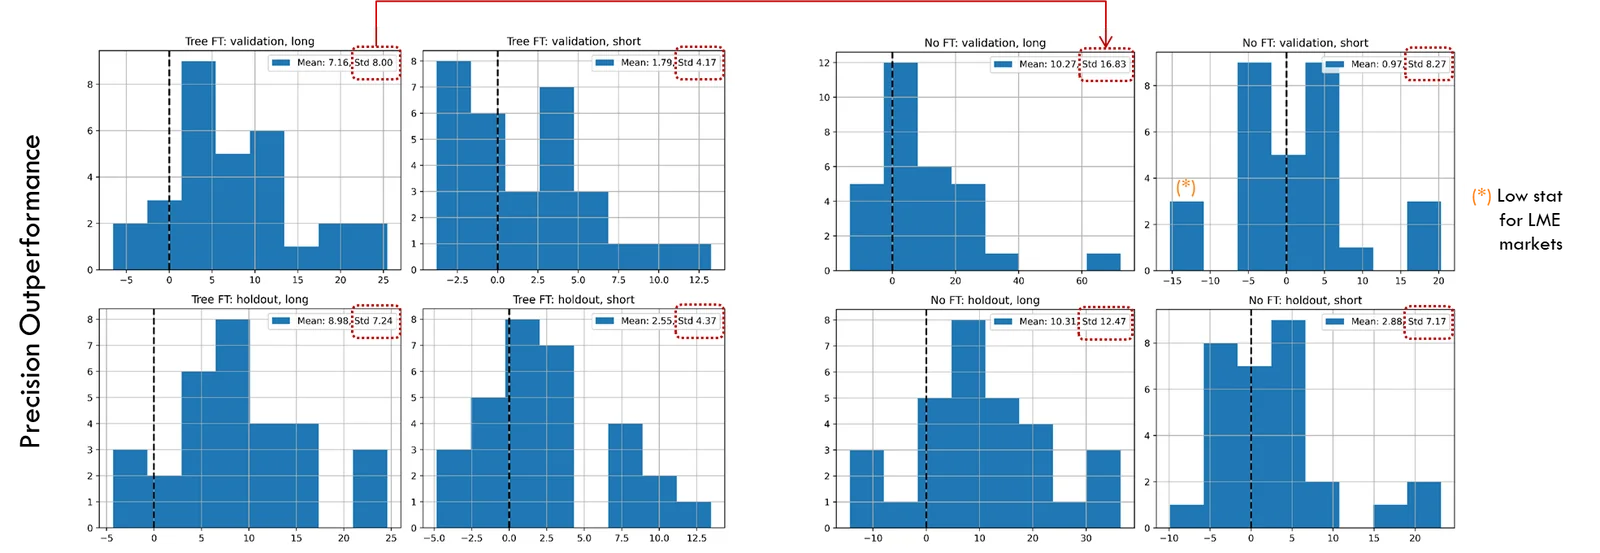
預測績效
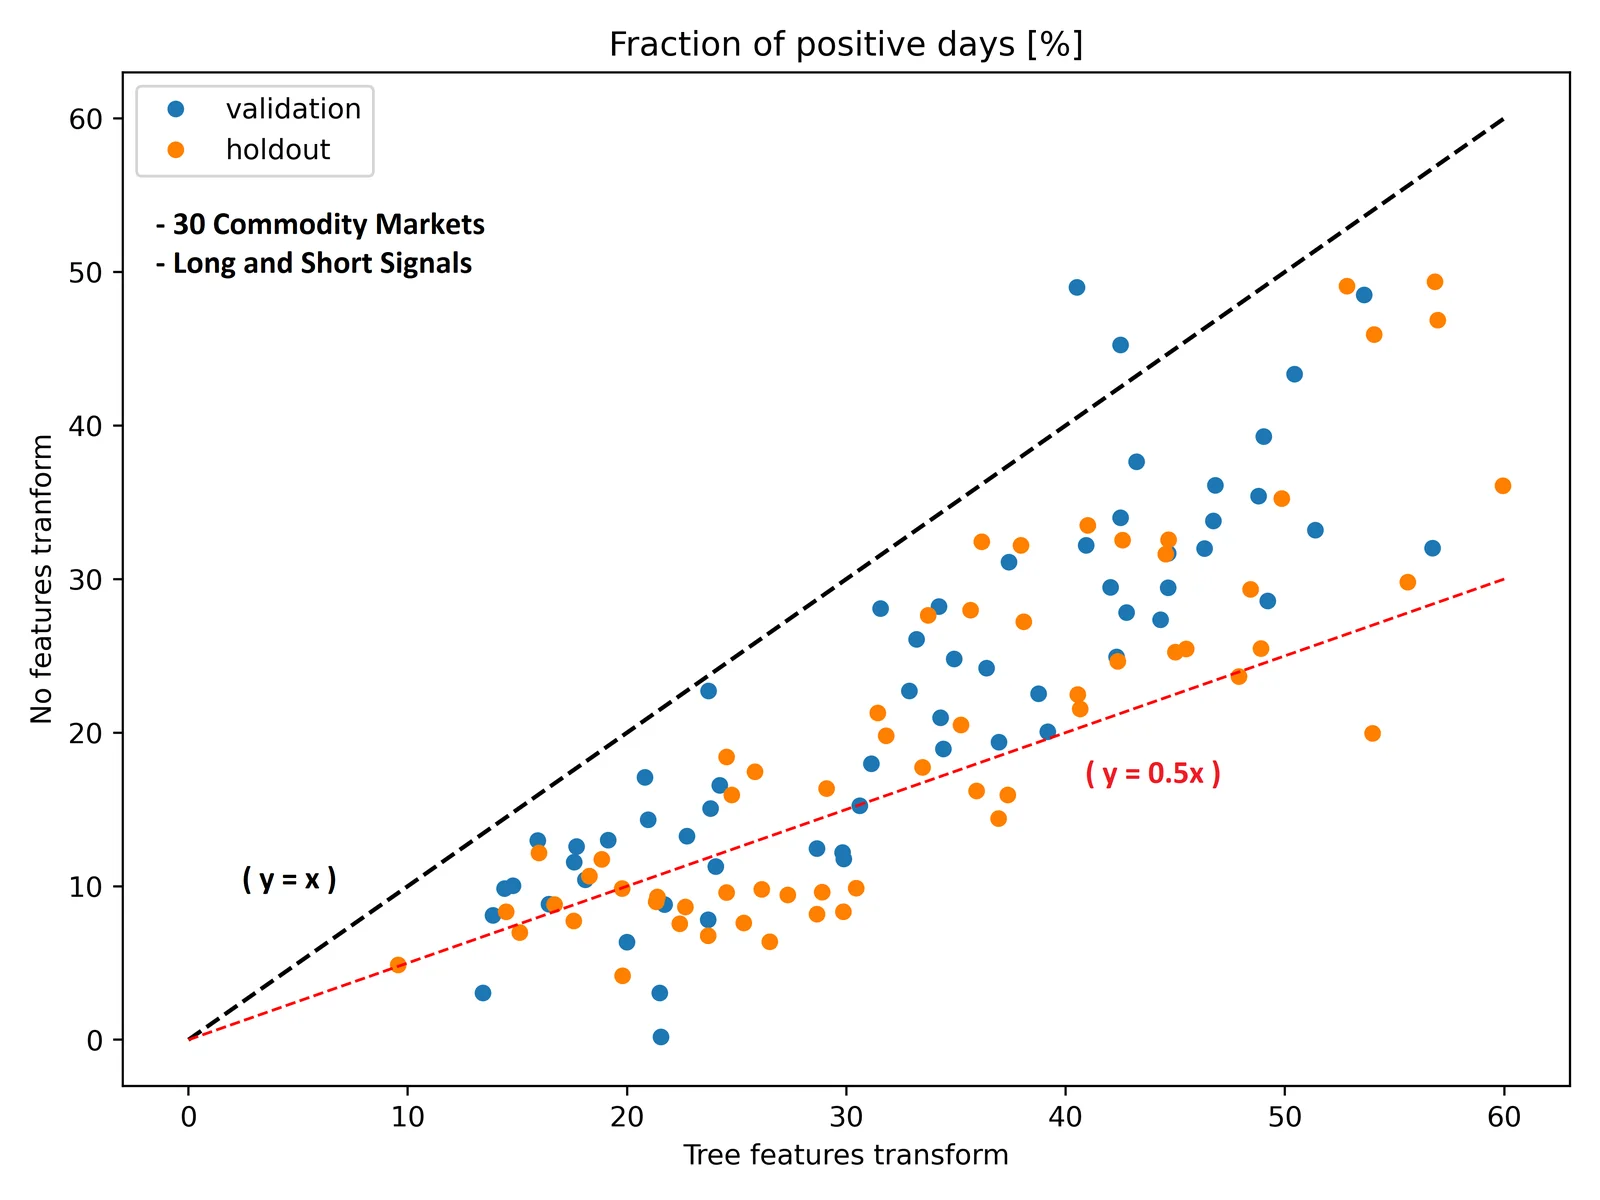
- 使用樹狀特徵轉換(FT)與不使用 FT 的預測結果相近,例如前者變異數較小,後者平均值略大。
- 不使用任何 FT 時所觀察到的較大變異數,與判定為正類的天數較少的傾向有關(請參閱下一張投影片)。
特徵轉換的影響
- 以集成樹模型為基礎的特徵轉換(FT):
- 將特徵數量(與樹的數量成正比)減少至少一個數量級。
- 完整 CML 策略的預測精確率/績效,與不使用任何特徵轉換時相近。
- 然而,模型判定為正類的天數比例始終較高。
- 由於預測優勢很小,策略要達到具參考價值的績效,需要大量的「交易日」,因此正類天數比例較高,使樹狀 FT 相較於不使用 FT 更具優勢。
- 以 SVM 模型為基礎的特徵轉換:
- 支援向量(SV)的數量通常略多於所使用資料點數量的一半。
- 以 SV 搭配核函數及對偶係數所建構的特徵數量,往往超過原始特徵數量。
- 相較於樹狀 FT,SVM 版本未觀察到任何可改善之處。
結論
- 本研究探討在 CML 策略中使用特徵轉換的影響,目前此特徵轉換以集成樹模型為基礎。
- 研究在模型預測層級進行,以避免下游策略面向所造成的差異,但著重於預期與最終策略績效最相關的指標。
- 目前以集成樹模型為基礎的 FT 大幅減少特徵數量,模型績效與不使用任何 FT 時相近,但判定為正類的天數較多。
- 由於預測優勢很小,策略要達到具參考價值的績效需要許多「交易日」,因此這被視為一項優勢。
- 比較中也納入以 SVM 模型為基礎的 FT,但相較於樹狀 FT,並未觀察到任何可改善之處。