
特徴量変換:木アンサンブルと SVM の比較
英語からの翻訳です。英語の原文を正とします。 英語で読む
問い
問い:
- AiLA の CML 戦略は、分類を用いた特徴量変換のステップを採用しています。これは、非線形な関係への対応と、潜在的に多数となる特徴量に関する正則化を助けることを意図したものです[詳細は CML のモデリングのセクションを参照]。
- 特徴量変換にはどのような効果があるでしょうか。
- 木アンサンブルの手法を SVM に置き換えると、どうなるでしょうか。
アプローチ:
- 戦略のパフォーマンスに関連する指標として、モデルの適合率と、正に分類された日数に焦点を当てます。
- 同じデータ標本とアーキテクチャの設定を用い、特徴量変換のステップのみを変えることで、条件を揃えて比較します。
適合率の超過:
- CML 戦略が予測した標本における真のラベルの割合から、データ標本全体における割合を差し引いたもの。
- 大半の資産で真の事例の割合が高くなり、結果は検証データとホールドアウト・データの間で一貫しています。
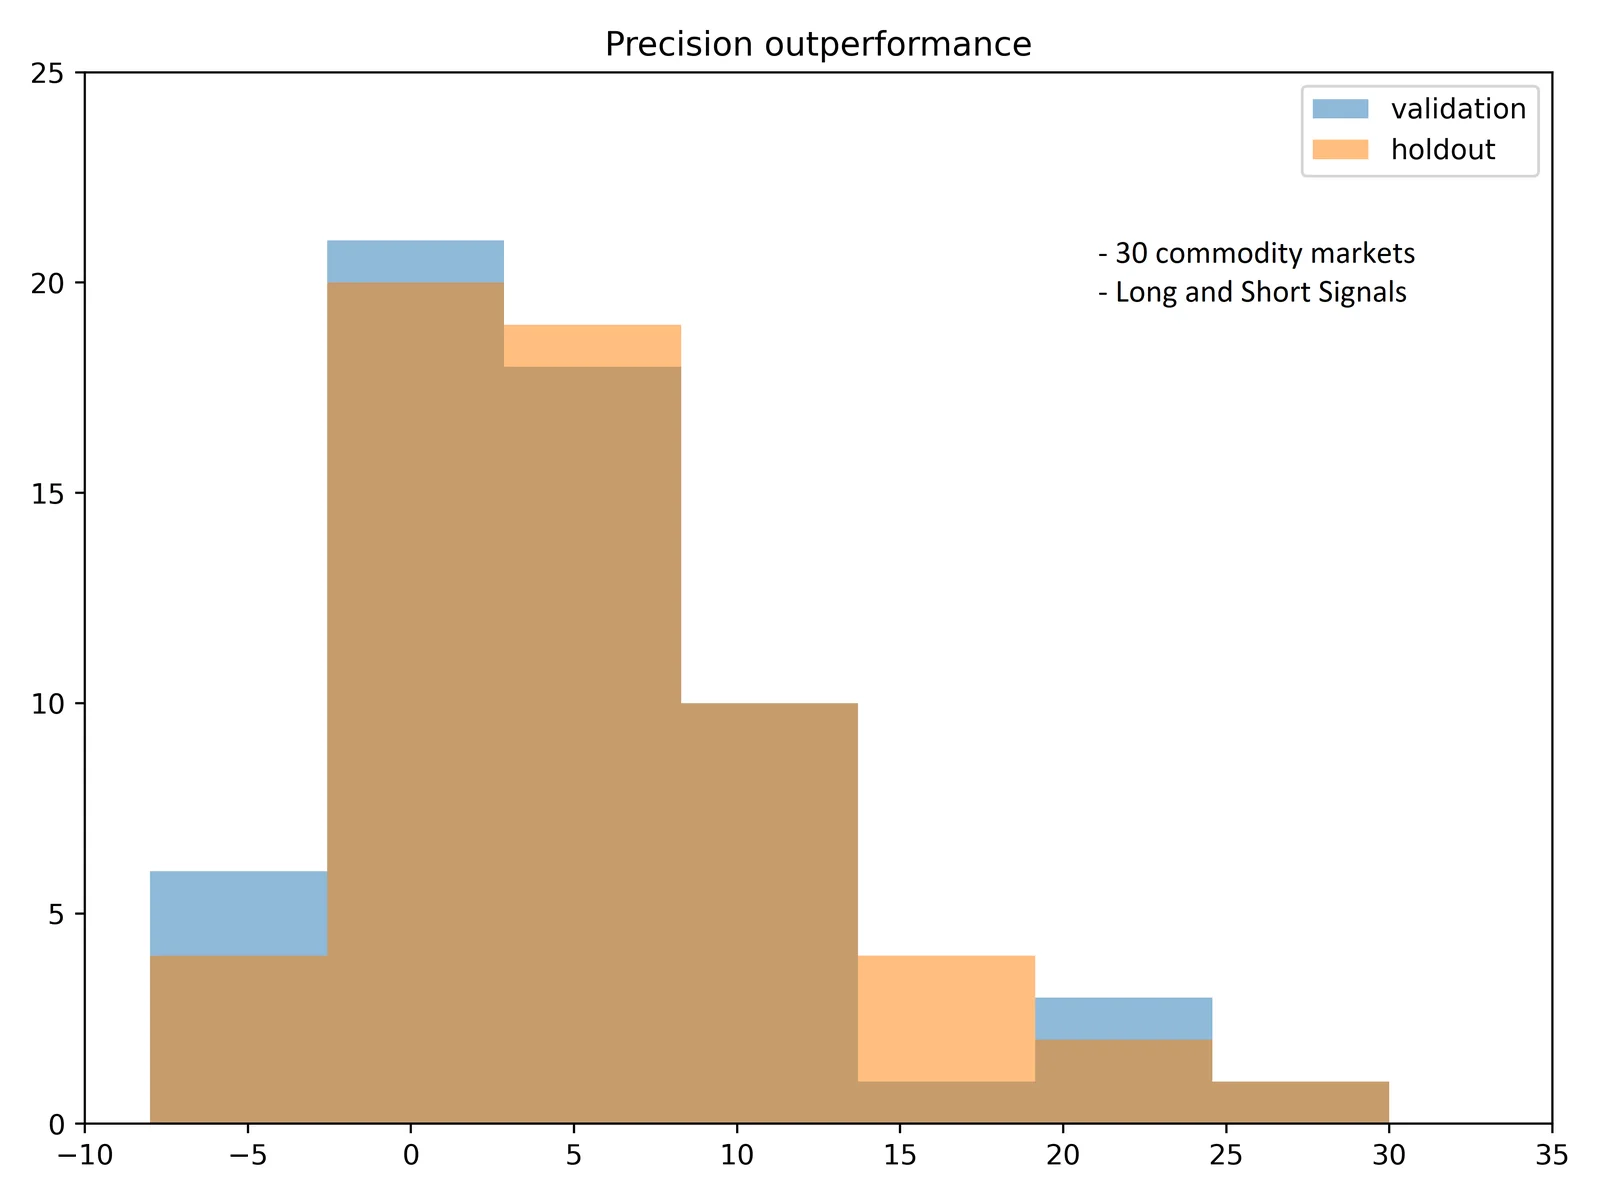
整合性の確認
- 本調査には、2021 年のデータを含めることや、ハイパーパラメータを固定のセットとすることなど、[CML のモデリングのセクション]の分析とのわずかな違いがあります。
- しかし、こうしたわずかな違いを踏まえても、予測結果の間には概して良好な整合性が見られました。
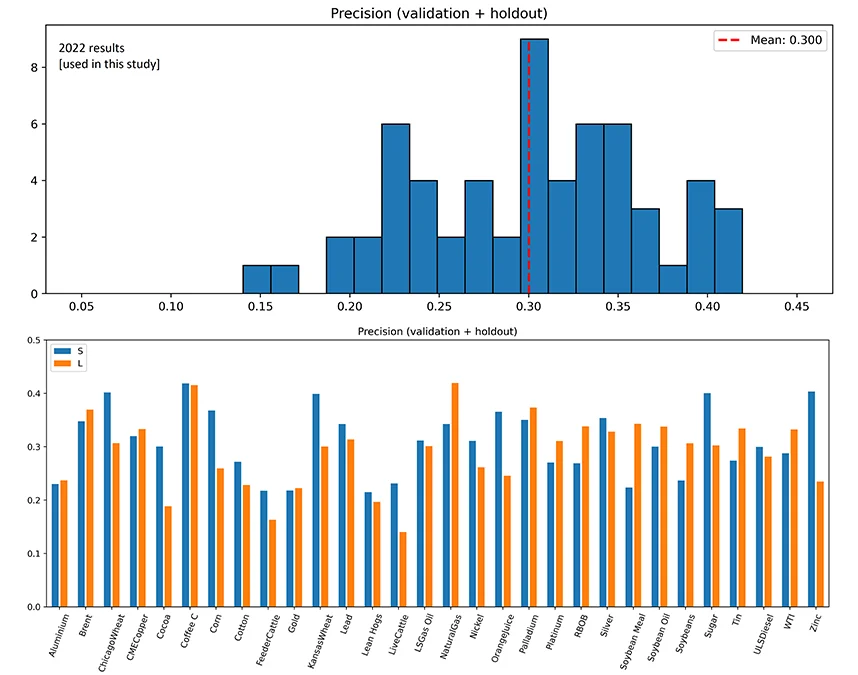
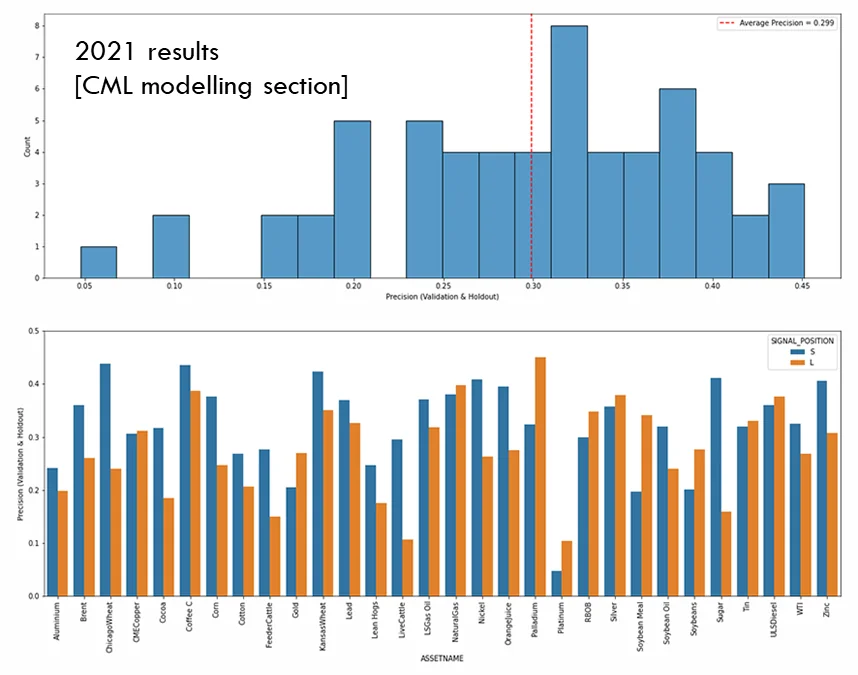
予測のパフォーマンス
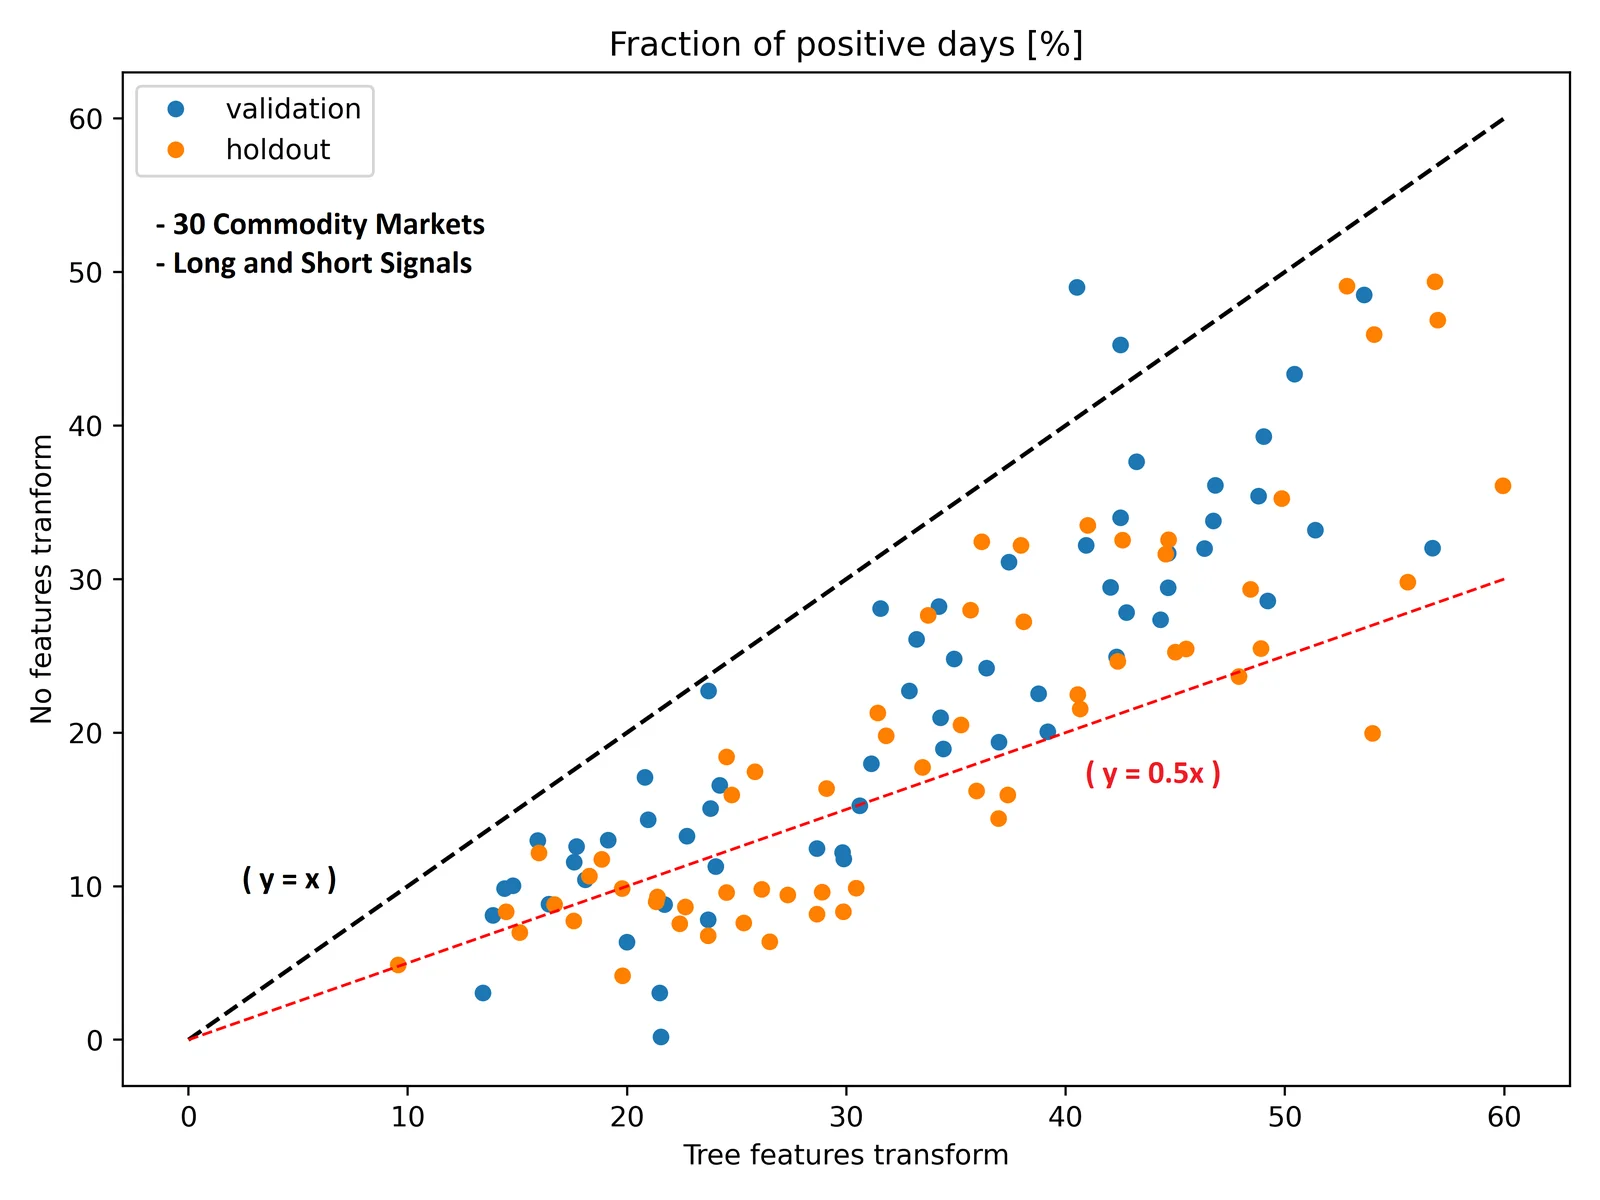
- 木ベースの特徴量変換(FT)を用いた場合と FT を用いない場合とで、予測結果は同程度でした。例えば、前者は分散がより小さく、後者は平均がやや大きくなっています。
- FT を一切用いない場合に見られるより大きな分散は、正に分類する日数が少なくなる傾向に関係しています(次のスライドを参照)。
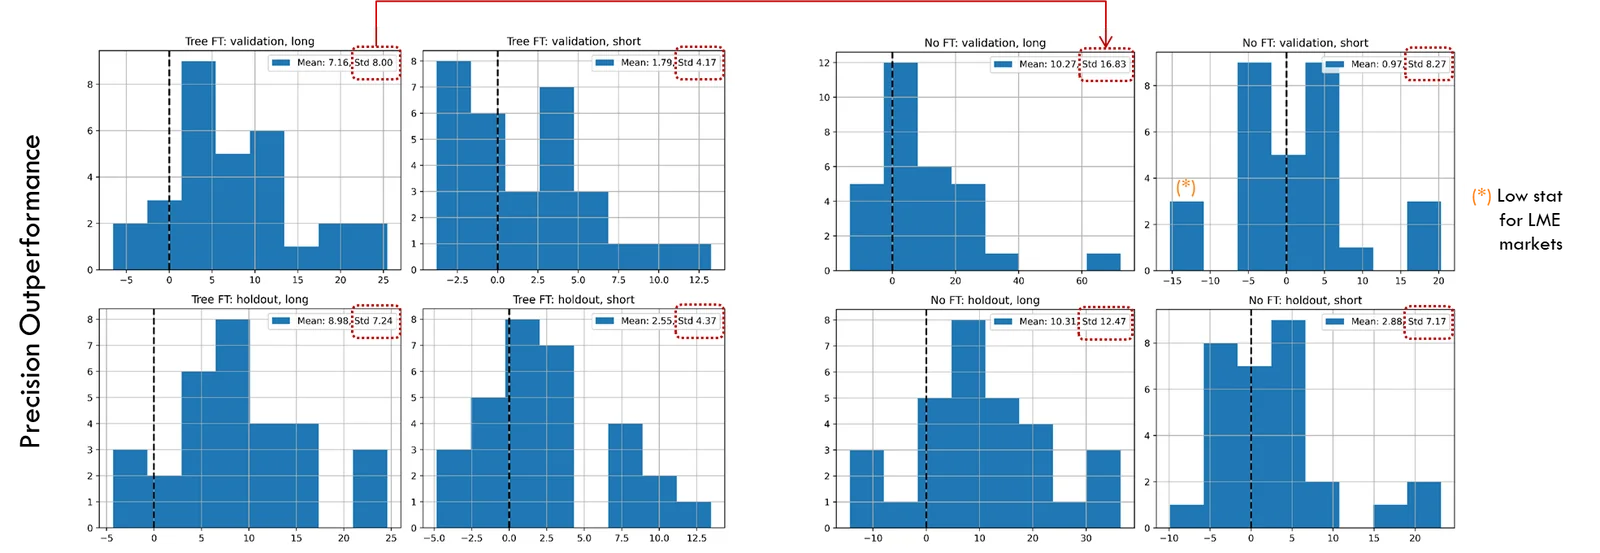
特徴量変換の影響
- 木アンサンブル・モデルに基づく特徴量変換(FT)は、
- 特徴量の数を少なくとも 1 桁削減します(木の数に比例)。
- CML 戦略全体の予測の適合率/パフォーマンスは、特徴量変換を一切用いない場合と同程度です。
- ただし、モデルによって正に分類される日の割合は一貫して大きくなります。
- 予測の優位性は小さいため、戦略として意味のあるパフォーマンスを得るには多くの「取引日」が必要です。このため、正に分類される日の割合が大きいことは、FT を用いない場合よりも木ベースの FT を用いることを支持する材料となります。
- SVM モデルに基づく特徴量変換では、
- 通常、サポート・ベクトル(SV)の数は、使用したデータ点の数の半分をやや上回ります。
- SV をカーネルおよび双対係数とともに用いて構築した特徴量の数は、元の特徴量の数を上回ることが多くありました。
- SVM 版では、木ベースの FT に対して改善が見られる領域はありませんでした。
結論
- CML 戦略で特徴量変換を用いることの影響を調べました。現在の特徴量変換はアンサンブル木モデルに基づいています。
- 下流の戦略の側面によって生じる違いを避けるため、調査はモデルの予測レベルで行いましたが、最終的な戦略のパフォーマンスに最も関連すると予想される指標に焦点を当てました。
- アンサンブル木モデルに基づく現在の FT は、特徴量の数を劇的に削減し、FT を一切用いない場合と同程度のモデル・パフォーマンスとなりましたが、正に分類される日数はより多くなりました。
- 予測の優位性は小さく、戦略として意味のあるパフォーマンスを得るには多くの「取引日」が必要であることから、これは利点と考えられます。
- 比較には SVM モデルに基づく FT も含めましたが、木ベースの FT と比べて改善が見られる領域はありませんでした。