
Analyser le surapprentissage
Traduit de l’anglais. Le texte anglais fait foi. Lire en anglais
Risque de surapprentissage
Vue d’ensemble
- Comme toutes les stratégies de trading systématique, les stratégies AiLA courent le risque de reposer sur des résultats surappris.
- Même avec les meilleures intentions et en suivant les meilleures pratiques en vigueur, rien ne garantit d’éviter le surapprentissage, qui peut par exemple résulter d’une influence involontaire des expériences passées.
- Afin de s’efforcer activement de réduire au minimum l’effet du surapprentissage, le développement des stratégies AiLA suit rigoureusement un ensemble de principes.
Plan
- Types : synthèse des sources de surapprentissage couramment envisagées aux différentes étapes de R&D d’une stratégie.
- Risque : mise en évidence des principales étapes du processus des stratégies AiLA au regard du risque de surapprentissage.
- Atténuation : description des principes suivis par AiLA pour réduire le risque de surapprentissage.
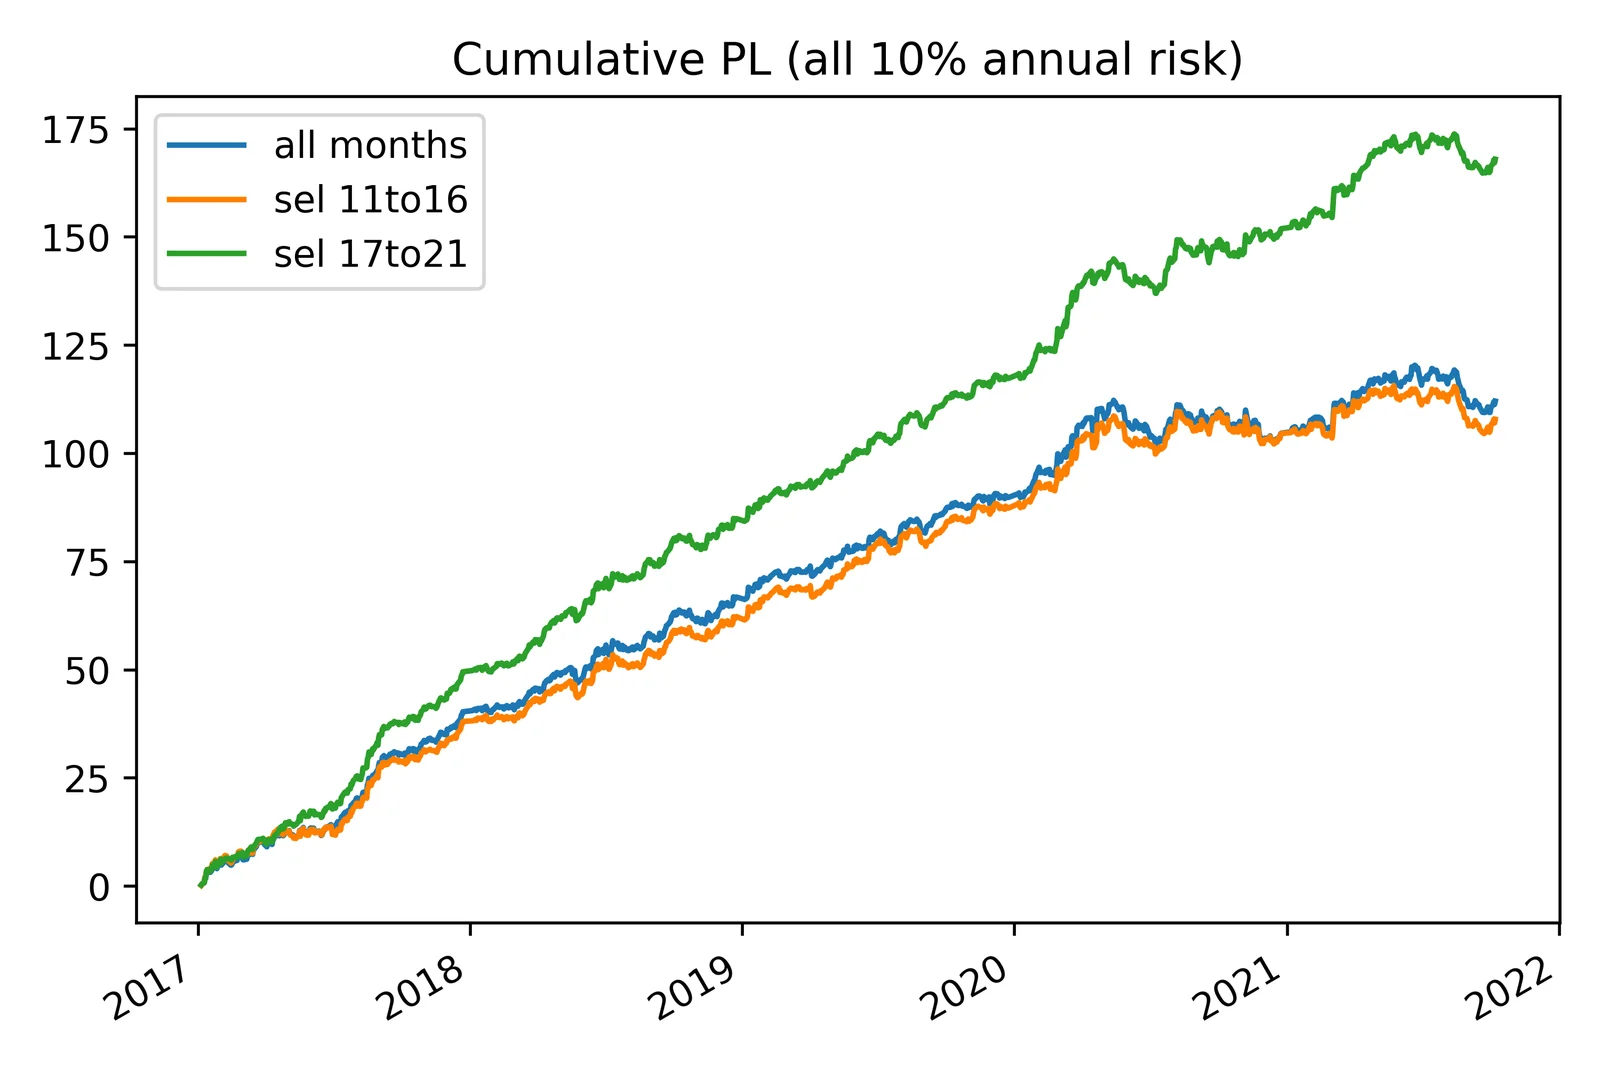
- Illustration de résultats de stratégie surappris ; pour plus de détails, voir la note Perspectives [Overfitting Risk].
- Une amélioration de stratégie conçue à partir des mêmes données que celles utilisées pour l’évaluer affiche une meilleure performance que la stratégie par défaut (2017 à 2021).
- La même stratégie améliorée, appliquée à d’autres données (2011 à 2016), montre que l’hypothèse n’a aucun effet.
Types de surapprentissage
Le surapprentissage est souvent envisagé à différents stades du processus de R&D ; deux types courants sont présentés ci-dessous.
Cette terminologie est courante en apprentissage automatique (ML), mais les problèmes ne sont pas propres au ML : ils concernent tout exercice dans lequel des données sont consultées.
Stade de l’entraînement (conception)
- Il s’agit du surapprentissage qui survient pendant la phase d’entraînement ou de conception de la stratégie.
- À ce stade, le surapprentissage est dans une certaine mesure inévitable, et différentes méthodes sont utilisées pour traiter les problèmes liés à l’ajustement d’une relation au bruit des données de l’échantillon.
Stade des tests
- Il s’agit du surapprentissage qui survient pendant la phase de test de la stratégie, où aucun surapprentissage n’est voulu.
- Il découle souvent de scénarios de tests multiples, tels que « tester beaucoup et retenir le meilleur » ou « tester, modifier puis tester à nouveau », dans lesquels la raison pour laquelle les résultats sont flatteurs est négligée (souvent involontairement) lors de l’évaluation finale.
Exemples de mesures contre le surapprentissage
Stade de l’entraînement (conception)
- Les techniques de validation croisée servent à vérifier la capacité à reproduire (généraliser) les résultats sur des données hors échantillon.
- Les techniques de régularisation servent à réduire la complexité du modèle ainsi que sa sensibilité à l’échantillon de données particulier.
- Les modèles d’ensemble peuvent servir à réduire la variance des résultats du modèle, qui devient ainsi plus robuste face au surapprentissage.
Stade des tests
- Garder la trace des multiples tests effectués et recourir à des méthodes pour en corriger ou en estimer l’effet, par exemple des tests à l’échelle de la famille (familywise) ou une performance dégonflée (deflated).
- Appliquer une politique stricte d’enregistrement préalable des détails des tests et d’utilisation de données différentes (« à l’aveugle »).
L’illustration ci-dessus [Overfitting Risk] a été facilement mise en évidence par validation croisée ; le surapprentissage (involontaire) au stade des tests est en revanche généralement bien plus difficile à quantifier.
Zones de risque
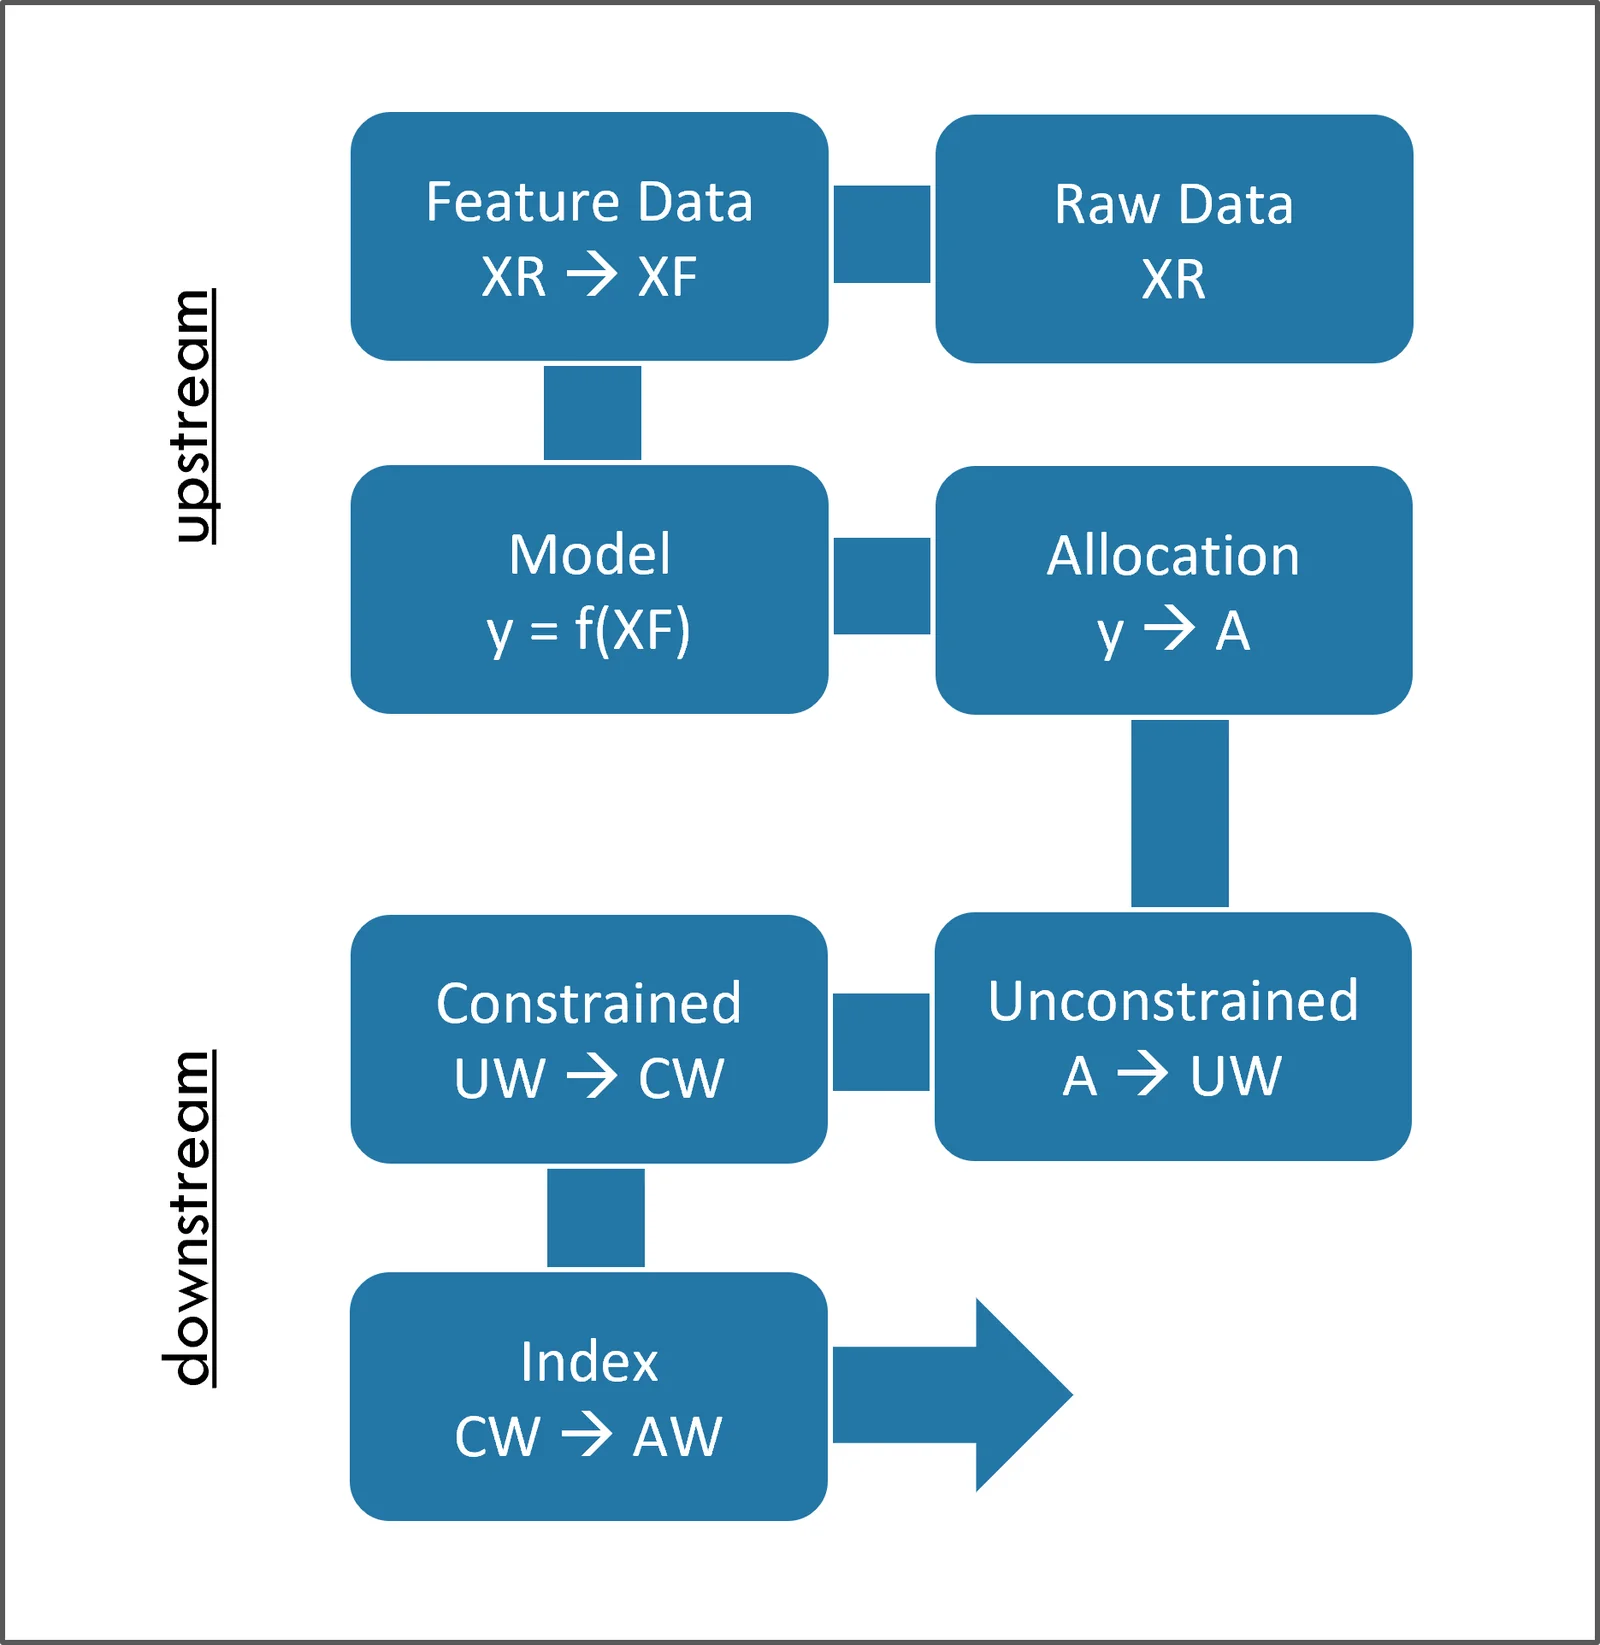
Tout au long du processus de développement des stratégies AiLA, le surapprentissage peut survenir à plusieurs occasions.
Zones particulièrement à risque
- Les choix relatifs aux données micro et macro et à la définition des variables : il s’agit de permettre au mieux aux données de faire apparaître les facteurs importants, sans présupposer la manière dont la stratégie doit les utiliser.
- L’entraînement et la sélection des modèles d’actifs. Les techniques mentionnées ci-dessus sont alors utilisées pour traiter le surapprentissage, et toute l’évaluation des modèles ainsi que le réglage des hyperparamètres s’effectuent sur un jeu de données d’entraînement et de validation prédéterminé.
- La méthode finale d’allocation amont est elle aussi optimisée quant à ses paramètres sur le même jeu de données d’entraînement et de validation.
- La construction des indices en aval combine différents modèles d’allocation d’actifs en indices de différents types. Ce processus repose sur une méthode fixe, centrée sur l’obtention d’un risque diversifié à l’échelle du portefeuille plutôt que sur la performance des actifs. Cette étape comporte toutefois des choix de paramètres et une sélection des actifs de l’indice, pour lesquels il faut éviter d’introduire un biais de sélection.
Principes d’atténuation
Afin de réduire l’effet du surapprentissage, un certain nombre de principes sont rigoureusement respectés.
Il convient toutefois de noter que toutes les approches ont leurs limites et que la prudence est de mise pour toutes les décisions.
Principes suivis
- Toutes les données des variables doivent rester disponibles dans un avenir prévisible et, comme pour les définitions des variables, aucune modification n’y est apportée une fois le modèle d’actif figé. Les choix de données et de définition des variables reposent sur une connaissance du domaine acquise par la pratique du trading fondamental et discrétionnaire de matières premières, qui pourrait être réexaminée au fil du temps. Toutefois, compte tenu de l’accent mis sur les facteurs stationnaires, le principe retenu consiste à figer également les aspects liés aux données, afin d’éviter un surapprentissage potentiel par le biais d’un tel processus de révision ou de mise à jour.
- L’entraînement et la sélection des modèles d’actifs reposent strictement sur les données disponibles jusqu’à fin 2016, ce qui coïncide aussi avec la période à l’issue de laquelle les modèles d’allocation d’actifs de la plupart des matières premières liquides ont été figés et mis en trading réel. Pour cette raison, cette période sert également à l’entraînement et à la validation des nouveaux travaux de recherche et des nouveaux modèles d’actifs.
- L’optimisation des paramètres dans l’échantillon pour la méthode finale d’allocation d’actifs pourrait entraîner un biais de sélection. La plage de valeurs est toutefois bornée, de sorte qu’elle ne devrait pas avoir d’effet spectaculaire sur les résultats, et ceux-ci sont validés par l’absence de surapprentissage significatif dans les résultats hors échantillon.
- Le test de l’ensemble du modèle amont d’allocation d’actifs exige que tous les détails soient figés avant l’obtention des résultats de test hors échantillon sur les données réservées (hold-out) à partir du 1er janvier 2017. La pratique stricte consistant à figer la méthode et à utiliser les jeux de données réservés pour l’évaluation finale du processus amont, courante au sein de la communauté du ML, est retenue comme principale mesure pour réduire le risque de sous-estimer, voire d’introduire par inadvertance, un effet flatteur sur les résultats dû à un biais de tests multiples. Pour la même raison, la plupart des modèles d’allocation des actifs liquides ont été figés au 1er janvier 2017 et n’ont pas été modifiés depuis, ce qui produit des résultats hors échantillon en conditions réelles.
- La construction des indices en aval fait intervenir des paramètres dont l’effet sur la performance est le plus souvent modeste, tels que l’objectif de volatilité ou les limites d’allocation, et pour lesquels les décisions reposent généralement sur des objectifs pratiques plutôt que sur la performance de l’indice. Il faut toutefois être vigilant, en particulier pour la sélection des actifs de l’indice, qui influe davantage sur la performance. Le principe général consiste ici à considérer les actifs sur un pied d’égalité et à n’introduire de discrimination entre eux que si elle est justifiée au stade de l’entraînement et étayée par les résultats des tests hors échantillon.