
Overfitting analysieren
Aus dem Englischen übersetzt. Maßgeblich ist der englische Text. Auf Englisch lesen
Das Risiko des Overfittings
Überblick
- Wie alle systematischen Handelsstrategien unterliegen auch AiLA-Strategien dem Risiko, auf überangepassten Ergebnissen zu beruhen.
- Selbst bei besten Absichten und unter Einhaltung der besten gängigen Praktiken gibt es keine Garantie, Overfitting zu vermeiden, etwa weil man unbeabsichtigt von früheren Erfahrungen beeinflusst wird.
- Um die Auswirkungen von Overfitting aktiv zu minimieren, folgt die Entwicklung der AiLA-Strategien strikt einer Reihe von Grundsätzen.
Gliederung
- Arten: Zusammenfassung der üblicherweise betrachteten Quellen von Overfitting in den verschiedenen Schritten der Strategieforschung und -entwicklung (F&E).
- Risiko: Hervorhebung der wichtigsten Schritte im AiLA-Strategieprozess, in denen Overfitting auftreten könnte.
- Minderung: Beschreibung der AiLA-Grundsätze, mit denen das Risiko von Overfitting verringert wird.
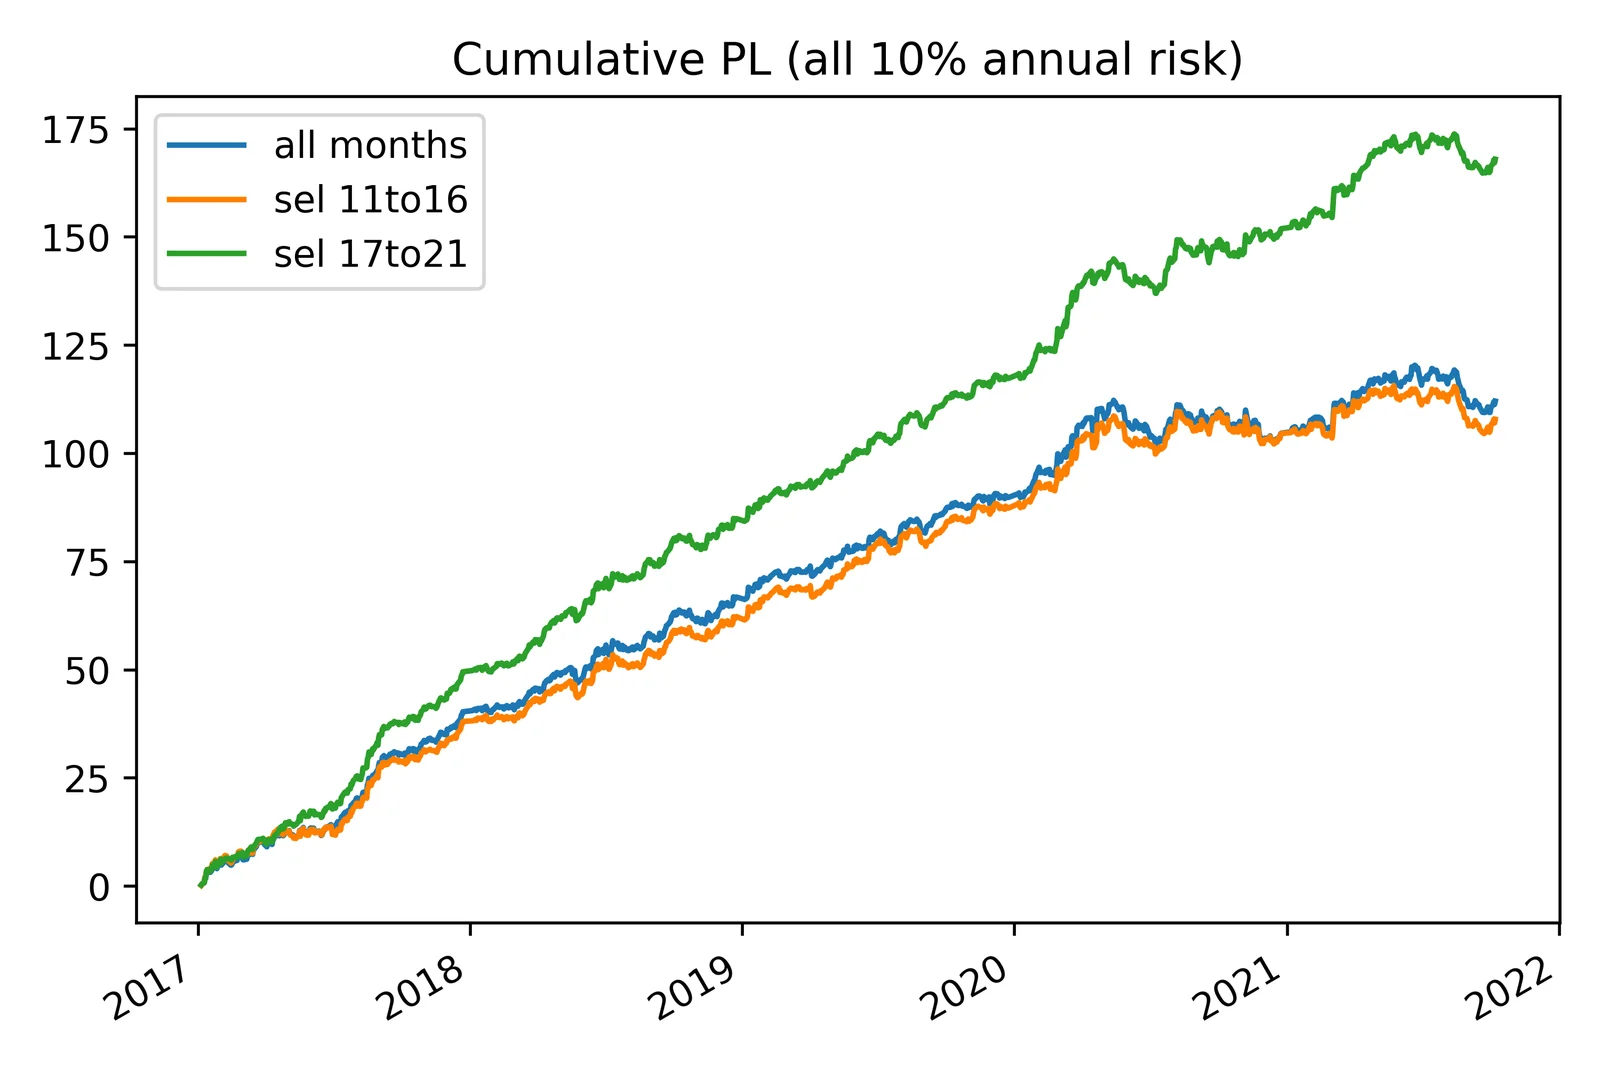
- Veranschaulichung überangepasster Strategieergebnisse; Einzelheiten siehe Perspektive [Overfitting-Risiko].
- Eine Strategieverbesserung, die mit denselben Daten entworfen wurde, mit denen sie bewertet wird, zeigt eine bessere Performance als die Standardstrategie (2017 bis 2021).
- Dieselbe verbesserte Strategie auf Basis anderer Daten (2011 bis 2016) zeigt, dass die Hypothese keine Wirkung hat.
Arten von Overfitting
Overfitting wird häufig in verschiedenen Phasen des F&E-Prozesses betrachtet; zwei verbreitete Arten folgen unten.
Die Terminologie ist im maschinellen Lernen (ML) gebräuchlich, die Probleme sind jedoch nicht ML-spezifisch, sondern betreffen jede Übung, bei der Daten herangezogen werden.
Trainingsphase (Entwurfsphase)
- Gemeint ist Overfitting, das in der Trainings- oder Entwurfsphase der Strategie auftritt.
- Hier ist Overfitting bis zu einem gewissen Grad unvermeidlich; mit verschiedenen Methoden wird den Problemen begegnet, die entstehen, wenn ein Zusammenhang an das Rauschen der In-Sample-Daten angepasst wird.
Testphase
- Gemeint ist Overfitting, das in der Testphase der Strategie auftritt, in der kein Overfitting beabsichtigt ist.
- Es entsteht häufig durch mehrfache Testszenarien wie „viele testen und das beste auswählen“ oder „testen, dann ändern und erneut testen“, wobei der Grund für die geschönten Ergebnisse bei der abschließenden Bewertung (oft unbeabsichtigt) übersehen wird.
Beispiele für Maßnahmen gegen Overfitting
Trainingsphase (Entwurfsphase)
- Kreuzvalidierungsverfahren prüfen, ob sich Ergebnisse in Out-of-Sample-Daten reproduzieren (verallgemeinern) lassen.
- Regularisierungsverfahren verringern die Modellkomplexität sowie die Empfindlichkeit gegenüber der konkreten Datenstichprobe.
- Ensemble-Modelle können die Varianz der Modellergebnisse verringern und sie so robuster gegenüber Overfitting machen.
Testphase
- Durchgeführte Mehrfachtests dokumentieren und Methoden zur Korrektur oder Abschätzung ihrer Wirkung einsetzen, z. B. familienweise Tests (Familywise Tests) oder eine deflationierte Performance.
- Strikte Regeln für vorab festgelegte Testdetails und die Verwendung anderer („blinder“) Daten durchsetzen.
Das obige Beispiel [Overfitting-Risiko] ließ sich mit Kreuzvalidierung leicht aufdecken; (unbeabsichtigtes) Overfitting beim Testen ist dagegen in der Regel weit schwieriger zu quantifizieren.
Risikobereiche
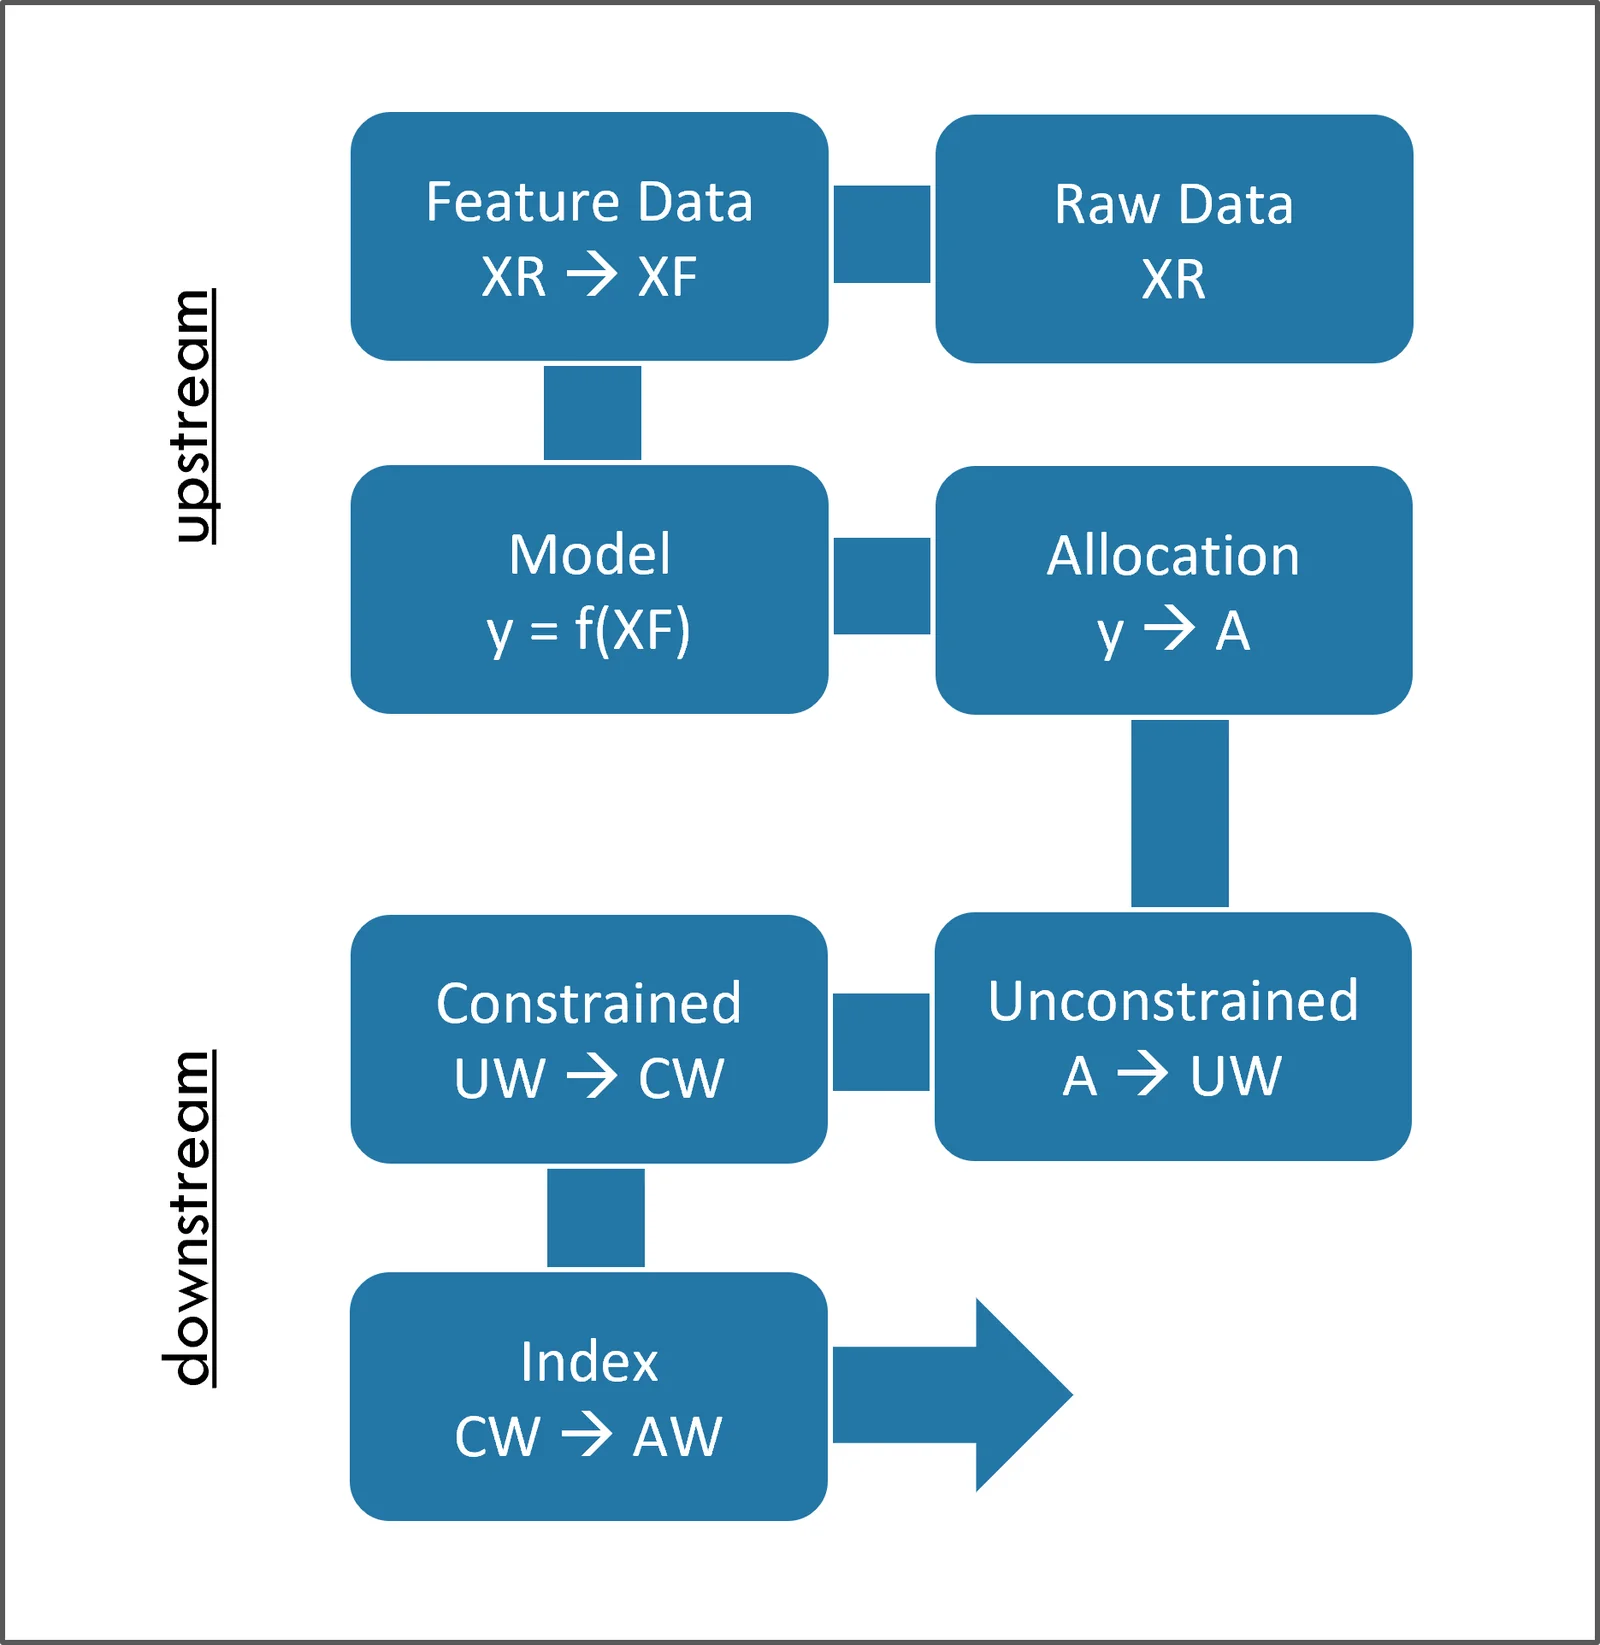
Im gesamten Entwicklungsprozess der AiLA-Strategien gibt es mehrere Gelegenheiten, bei denen Overfitting auftreten kann.
Besonders risikobehaftete Bereiche
- Entscheidungen über die Mikro- und Makrodaten und die Definition der Features: Hier geht es darum, wie die Daten wichtige Faktoren am besten sichtbar machen können, ohne vorzugeben, wie die Strategie sie nutzen soll.
- Training und Auswahl der Asset-Modelle. Hier werden Verfahren wie die oben genannten gegen Overfitting eingesetzt, und alle Modellbewertungen und die Abstimmung der Hyperparameter erfolgen anhand eines vorab festgelegten Trainings- und Validierungsdatensatzes.
- Auch die Parameter der finalen vorgelagerten Allokationsmethode werden anhand desselben Trainings- und Validierungsdatensatzes optimiert.
- Die nachgelagerte Indexkonstruktion kombiniert verschiedene Asset-Allokationsmodelle zu Indizes unterschiedlicher Art. Dieser Prozess beruht auf einer festen Methode, deren Schwerpunkt eher auf einem über das Portfolio diversifizierten Risiko als auf der Performance einzelner Assets liegt. Dieser Schritt umfasst jedoch die Wahl von Parametern und die Auswahl der Index-Assets, wobei eine Selektionsverzerrung (Selection Bias) unbedingt vermieden werden muss.
Grundsätze zur Minderung
Um die Auswirkungen von Overfitting zu verringern, werden eine Reihe von Grundsätzen strikt eingehalten.
Dabei ist jedoch zu beachten, dass alle Ansätze Schwächen haben und bei allen Entscheidungen Vorsicht geboten ist.
Befolgte Grundsätze
- Alle Feature-Daten sollen auf absehbare Zeit verfügbar sein; an ihnen und an den Feature-Definitionen werden nach dem Einfrieren des Asset-Modells keine Änderungen mehr vorgenommen. Die Entscheidungen zu Daten und Feature-Definitionen beruhen auf Fachwissen aus der Praxis des fundamentalen bzw. diskretionären Rohstoffhandels, das im Lauf der Zeit überprüft werden könnte. Angesichts des Fokus auf stationäre Faktoren gilt jedoch der Grundsatz, auch die Datenaspekte einzufrieren, um ein mögliches Overfitting durch einen solchen Überprüfungs- oder Aktualisierungsprozess zu vermeiden.
- Training und Auswahl der Asset-Modelle beruhen strikt auf Daten, die bis Ende 2016 verfügbar waren. Dies fällt zugleich mit dem Zeitpunkt zusammen, nach dem die Asset-Allokationsmodelle für die meisten liquiden Rohstoffe eingefroren wurden und im Live-Handel verfügbar waren. Deshalb wird dieser Zeitraum auch für Training und Validierung neuer Forschungsarbeiten und Asset-Modelle verwendet.
- Eine In-Sample-Optimierung der Parameter der finalen Asset-Allokationsmethode könnte zu einer Selektionsverzerrung führen. Der Wertebereich ist jedoch so begrenzt, dass keine dramatischen Auswirkungen auf die Ergebnisse zu erwarten sind, und die Ergebnisse werden dadurch bestätigt, dass in den Out-of-Sample-Ergebnissen kein nennenswertes Overfitting zu beobachten ist.
- Für den Test des gesamten vorgelagerten Asset-Allokationsmodells müssen alle Details eingefroren sein, bevor die Out-of-Sample-Testergebnisse anhand von Holdout-Daten ab dem 1. Januar 2017 ermittelt werden. Die strikte Praxis, die Methode einzufrieren und die Holdout-Datensätze für die abschließende vorgelagerte Bewertung zu verwenden, wie sie in der ML-Community üblich ist, wurde als wichtigste Maßnahme gewählt, um das Risiko zu verringern, einen durch Mehrfachtests (Multiple Testing Bias) geschönten Effekt auf die Ergebnisse zu unterschätzen und/oder versehentlich einzubeziehen. Aus demselben Grund wurden die meisten Allokationsmodelle für liquide Assets ab dem 1. Januar 2017 eingefroren und seitdem nicht mehr verändert, sodass sie Live-Out-of-Sample-Ergebnisse liefern.
- Die nachgelagerte Indexkonstruktion umfasst Parameter mit meist geringem Einfluss auf die Performance, etwa Volatilitätsziel und Allokationsgrenzen, und die Entscheidungen beruhen in der Regel eher auf praktischen Zielen als auf der Indexperformance. Dennoch ist Sorgfalt geboten, insbesondere bei der Auswahl der Index-Assets, die einen größeren Einfluss auf die Performance hat. Hier gilt der allgemeine Grundsatz, Assets gleichwertig zu behandeln und nur dann zwischen ihnen zu unterscheiden, wenn dies in der Trainingsphase begründet ist und durch die Out-of-Sample-Testergebnisse gestützt wird.